Mình vừa đọc xong một báo cáo khá thú vị của Google DeepMind, tựa đề “Conjecture Machines: AI agents and the new validation bottleneck in science” (tháng 7/2026), do Don Wallace, Conor Griffin, Sean O’Neill, Thang Luong và Owen Larter viết, dựa trên phỏng vấn 10 nhà nghiên cứu/kỹ sư của DeepMind. Nội dung xoay quanh một câu hỏi lớn: khi AI agent bắt đầu tự đề xuất giả thuyết, thiết kế thí nghiệm, thậm chí khám phá ra thuật toán tốt hơn con người — thì đâu là điểm nghẽn thật sự của khoa học?
Câu trả lời của báo cáo, gói gọn trong đúng một câu: tạo ý tưởng đang trở nên rẻ, nhưng kiểm chứng ý tưởng thì không.
Câu chuyện mở đầu: khi agent “đoán” đúng thứ mất cả thập kỷ để chứng minh
Báo cáo mở đầu bằng câu chuyện của nhà vi sinh vật học José Penadés (Imperial College London). Nhóm của ông mất gần một thập kỷ để tìm ra cách một họ siêu vi khuẩn kháng kháng sinh lây lan — kết quả chưa từng công bố, chỉ có nội bộ phòng lab biết.
Năm 2024, ông thử mô tả vấn đề này cho Co-Scientist, một AI agent của Google DeepMind. Trong vòng hai ngày, agent trả về 5 giả thuyết, xếp hạng ưu tiên. Giả thuyết số 1 chính là điều nhóm ông đã mất nhiều năm để chứng minh: một số siêu vi khuẩn “mượn” đuôi virus làm chìa khóa để nhảy giữa các loài vật chủ. Ông sốc đến mức nghĩ máy tính bị rò rỉ dữ liệu, phải email Google để xác minh — không có gì bị lộ cả.
Đây không phải câu chuyện “AI thay thế nhà khoa học”, mà là minh hoạ cho điều báo cáo muốn nói: agent có thể nén một quá trình tư duy nhiều năm xuống còn vài ngày.
Vì sao agent bỗng dưng hữu ích đến vậy?
Báo cáo chỉ ra ba lực đẩy, xếp thành một kim tự tháp:
- Frontier model mạnh hơn — các model hàng đầu giờ vượt qua chuyên gia con người trên những benchmark khó như Humanity’s Last Exam hay FrontierMath, nhờ inference-time reasoning: model “suy nghĩ” qua nhiều bước, tự khám phá và tự sửa trước khi chốt câu trả lời.
- Scaffolding — lớp “khung” bọc quanh model, cho nó bộ nhớ, khả năng gọi công cụ (chạy code, tra cứu literature, gọi các model chuyên biệt khác). Scaffolding đời đầu thường phải làm thủ công cho từng agent, khó tái sử dụng; các giao thức giao tiếp agent-với-agent mới đang giảm bớt gánh nặng này.
- Customisation — agent “skill”: những tập lệnh dạng văn bản đơn giản, cho phép nhà khoa học “dạy” agent kiến thức ngầm (tacit knowledge) của riêng họ — thứ vốn khó truyền đạt bằng lời, chỉ tích luỹ qua năm tháng làm nghề.
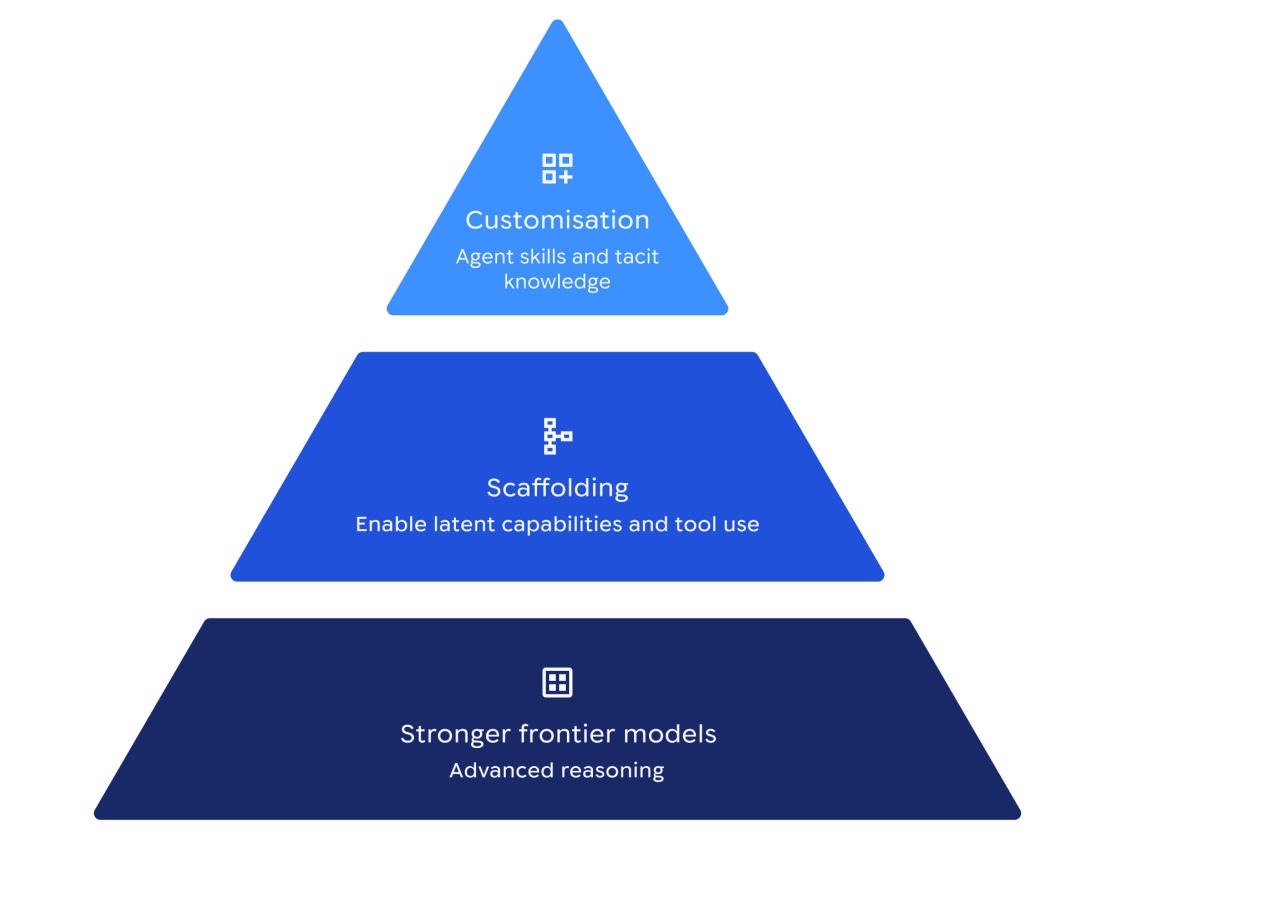 Ba lớp làm nên một agent hữu ích, theo báo cáo: model nền càng mạnh, scaffolding càng tốt thì càng “khai thác” được nhiều năng lực tiềm ẩn, và customisation là lớp giúp agent hiểu tri thức ngầm riêng của từng nhà khoa học.
Có một câu nói của nhà khoa học tính toán Natasha Latysheva mình rất thích: “Nghiên cứu khoa học sẽ chuyển từ thực thi trực tiếp sang điều phối ở tầm cao. Chúng ta sẽ bắt đầu ngày làm việc bằng cách xem lại những thí nghiệm agent chạy qua đêm.”
Agent giỏi “nghĩ ra ý tưởng”, nhưng không giỏi “chứng minh nó đúng”
Đây là phần mình thấy đáng suy ngẫm nhất của báo cáo. Có ba giai đoạn trong một chu trình khoa học: ideation (nghĩ giả thuyết) → tìm nghiệm tối ưu → validation (kiểm chứng). Agent đang tạo ra bước nhảy vọt ở hai giai đoạn đầu, nhưng gần như chưa giúp gì nhiều ở giai đoạn cuối.
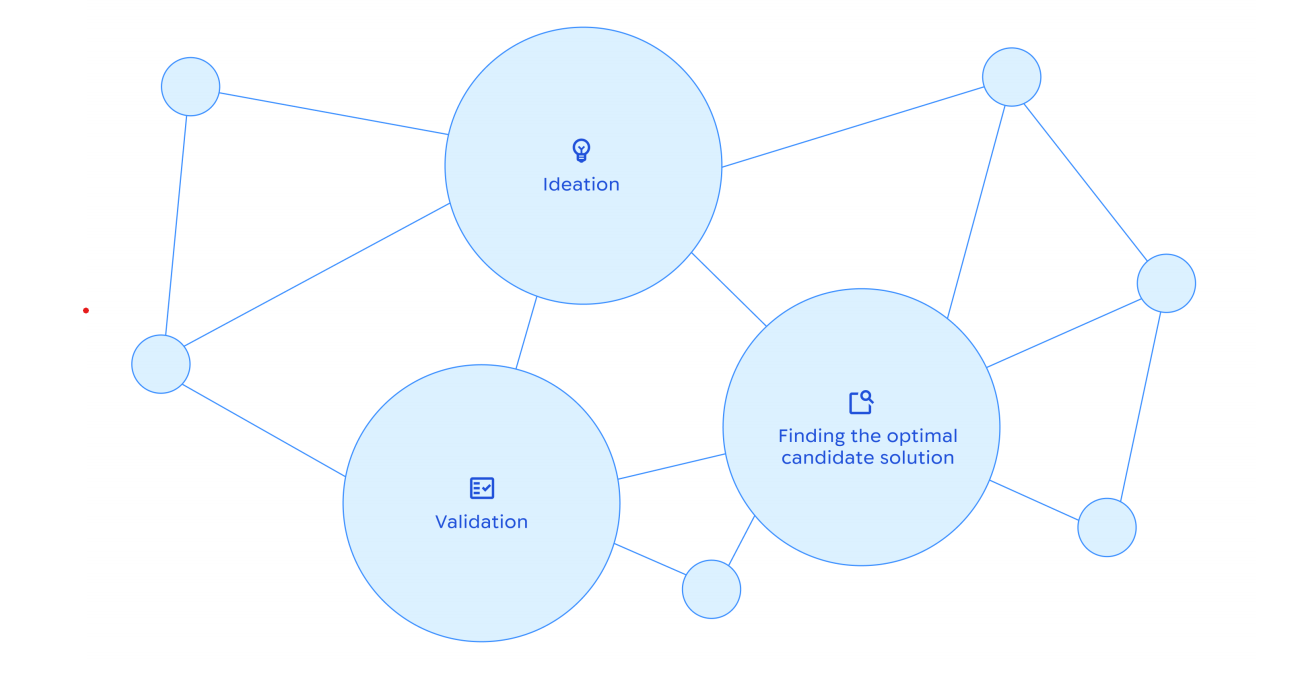 Ba giai đoạn của một chu trình khoa học. Agent đang tạo bước nhảy vọt rõ rệt ở “ideation” và “tìm nghiệm tối ưu” — nhưng “validation” thì gần như vẫn giậm chân tại chỗ, vì phải chạm vào thực tế vật lý.
Ideation: Co-Scientist điều phối một dàn subagent để sinh ra nhiều giả thuyết, tự phản biện, xếp hạng, lặp lại — mô phỏng cách một nhóm nghiên cứu con người vận hành, nhưng ở tốc độ khác hẳn. Ví dụ thực tế: Gary Peltz (Stanford) tìm thuốc có thể tái sử dụng để trị xơ gan. Ông chọn 2 ứng viên dựa trên kinh nghiệm nhiều thập kỷ — không cái nào hiệu quả. Co-Scientist chọn 3 ứng viên — 2 trong số đó không chỉ chặn được xơ hoá mà còn thúc đẩy tái tạo tế bào gan.
Nhưng đi kèm là rủi ro rất thật: “Một tuyên bố ảo giác (hallucination) duy nhất ở trang 10 của kết quả có thể làm mất giá trị toàn bộ tài liệu” — lời của Vivek Natarajan, trưởh nhóm Co-Scientist. Ông gọi thứ agent còn thiếu là “epistemic humility” — sự khiêm tốn nhận thức: biết khi nào mình không biết, và nói ra điều đó. AlphaFold làm được điều này (báo cáo độ tin cậy cho từng phần dự đoán), nhưng để hiệu chỉnh độ tự tin cho các suy luận khoa học mở hơn thì vẫn là bài toán chưa có lời giải.
Tìm nghiệm tối ưu: AlphaEvolve là ví dụ agent tìm kiếm nghiệm tốt nhất chứ không chỉ nghiệm chạy được, trong không gian giải pháp gần như vô hạn (thiết kế vật liệu, thuật toán…). Nó đã góp phần thiết kế chip TPU thế hệ mới của Google, giúp nhà toán học Terence Tao giải các bài toán Erdős còn mở, và cải thiện phân tích dữ liệu gen. Nhưng ngay cả với AlphaEvolve, kết quả đầu ra trong các lĩnh vực như vật liệu vẫn chỉ là ứng viên tiềm năng, chưa phải kết quả cuối — chất xúc tác vẫn phải được tổng hợp và đo đạc thật ở phòng lab.
Validation — nút thắt thật sự: Báo cáo dùng lại ý của Karl Popper: khoa học tiến bộ qua các cặp conjecture (phỏng đoán) — refutation (bác bỏ). AI agent đang biến agent thành “conjecture machine” — cỗ máy sản xuất phỏng đoán hàng loạt, rẻ. Nhưng refutation — bước kiểm chứng — vẫn mang tính vật lý và thể chế, nên vẫn chậm và tốn kém như cũ.
Toán học và khoa học máy tính là ngoại lệ thú vị vì có thể kiểm chứng in silico: agent sinh chứng minh, biểu diễn bằng ngôn ngữ hình thức (như Lean), rồi máy tính xác minh chắc chắn đúng/sai. DeepMind có công cụ Aletheia kết hợp bộ sinh chứng minh với một bộ xác minh ngôn ngữ tự nhiên gửi lỗi ngược lại để sửa. Trong thử thách “First Proof” đầu tiên (2/2026) với 10 bài toán chưa từng công bố, Aletheia giải được 6/10 — kết quả tốt nhất.
Nhưng đi kèm là một vấn đề mới: “proof indigestion” (khó tiêu hoá chứng minh) — cụm từ của Thang Luong, người dẫn dắt dự án Aletheia: “Chúng ta đang tiến tới một tương lai mà AI tạo ra đột phá nhanh hơn con người có thể review chúng.”
Ở hầu hết các ngành khác (sinh học, y dược, vật liệu…), khoảng cách kiểm chứng đang rộng ra chứ không thu hẹp lại. Agent có thể đề xuất một gene lead để đảo ngược lão hoá tế bào, nhưng không thể khẳng định nó thật sự hiệu quả. Đó là lý do các công ty như Google DeepMind, Ginkgo Bioworks, Lila Sciences đang đầu tư vào lab tự động hoá — nhưng công nghệ này còn đắt, còn sớm, và quan trọng hơn: tự động hoá không thể rút ngắn “đồng hồ sinh học” của tự nhiên. Dòng tế bào vẫn cần thời gian để lớn lên, phản ứng hoá học vẫn cần thời gian để hoàn tất. Cái lab, không phải cái model, mới là thứ quyết định tốc độ.
Bốn việc cần làm ngay, theo báo cáo
Phần cuối báo cáo dành cho các nhà hoạch định chính sách và quỹ tài trợ khoa học, đề xuất 4 ưu tiên:
- Đảm bảo mọi nhà khoa học đều tiếp cận được agent tốt nhất — coi đây là ưu tiên chiến lược ngang với việc từng cấp quyền truy cập siêu máy tính trước đây. Điều thú vị: tranh luận địa chính trị hiện nay tập trung vào việc “quốc gia nào tự train được frontier model”, trong khi câu hỏi quan trọng hơn có thể là “quốc gia đó có triển khai được agent trên toàn bộ hệ sinh thái khoa học của mình hay không”.
- Biến dữ liệu quốc gia thành “agent-ready” — mở API có tài liệu tốt cho dữ liệu công khai/rủi ro thấp; xây giải pháp bảo mật quyền riêng tư cho dữ liệu nhạy cảm (gene, virus học…) để agent truy cập an toàn, có audit.
- Giải quyết nút thắt kiểm chứng — đầu tư hạ tầng thí nghiệm sẵn có (cho thuê bench-time), đẩy nhanh lab tự động hoá. DeepMind đã mở một wet lab ngay trong Viện Francis Crick (Anh) để tài trợ nhà khoa học độc lập kiểm chứng giả thuyết do agent tạo ra.
- Trang bị agent cho người bình duyệt (peer reviewer) — vì bản thân giới khoa học cũng đang dùng AI để viết ngày càng nhiều đơn xin tài trợ và bài báo, khiến “chất lượng văn bản” không còn là thước đo đáng tin. Hội đồng Nghiên cứu Y khoa Anh (MRC) đã khôi phục lại vòng phỏng vấn cho ứng viên vào chung kết — một phản ứng khá “low-tech” trước vấn đề rất “high-tech”.
Một câu mình muốn giữ lại
Đoạn kết của báo cáo có một câu mình nghĩ đáng nhớ lâu:
AI agents must not be viewed as a rationale to spend less on science; this would be a tragic false economy.
(Tạm dịch: đừng biến sự xuất hiện của AI agent thành cái cớ để cắt giảm đầu tư cho khoa học — đó sẽ là một kiểu “tiết kiệm giả” đầy bi kịch.)
Đọc xong báo cáo, điều mình rút ra không phải là “AI sắp làm khoa học thay con người”, mà là: cỗ máy tạo giả thuyết đang chạy nhanh hơn rất nhiều so với cỗ máy kiểm chứng giả thuyết — và khoảng cách đó, chứ không phải bản thân con AI, mới là thứ đáng để đầu tư giải quyết trong vài năm tới.
Bài viết này là tóm tắt và một vài suy nghĩ cá nhân sau khi đọc báo cáo “Conjecture Machines: AI agents and the new validation bottleneck in science” (Google DeepMind, tháng 7/2026). Các trích dẫn trong bài đều lấy từ báo cáo gốc.