Trong thời đại bùng nổ nhu cầu triển khai chatbot hay trợ lý AI của doanh nghiệp, gần như tất yếu với các công ty có dữ liệu nhạy cảm hoặc ngành đặc thù cần kiến thức domain sâu, việc dùng một general model (GPT, Gemini,…) thường chưa đủ.
Các model general có thể làm rất giỏi các việc hằng ngày như tóm tắt, dịch, hỏi đáp hay suy luận, nhưng không biết doanh nghiệp thật sự đang làm gì. Để giải quyết bài toán này, hiện tại có 3 phương pháp chính: Prompt Engineering, RAG và Fine-tuning.
Bài này đi theo đúng mạch đó: điểm qua Prompt Engineering và RAG để thấy vì sao đôi khi phải chọn Fine-tuning, sau đó vào cách chuẩn bị dữ liệu training cho đúng, rồi cuối cùng là các kỹ thuật fine-tuning tiết kiệm tài nguyên — từ Full Fine-tuning đến LoRA, QLoRA và DoRA — cùng lý do từng kỹ thuật ra đời để giải quyết giới hạn của kỹ thuật trước nó.
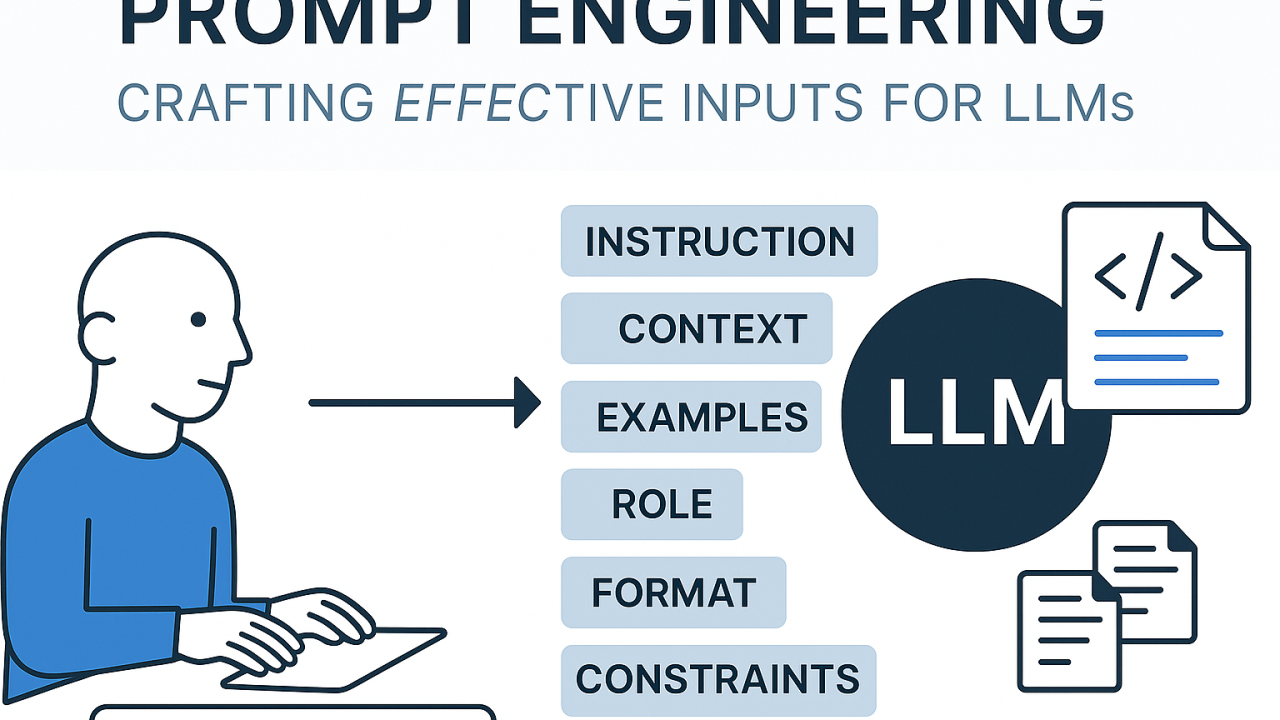
Prompt Engineering
Nhét hướng dẫn của user vào system prompt hiện tại, không thay đổi trọng số của model.
- Ưu điểm: nhanh, rẻ, dễ thử nghiệm, không cần retrain model & thu thập dataset.
- Nhược điểm: tràn context, tốn token, khó quản lý.
Note: Token là đơn vị nhỏ nhất mà LLM xử lý — có thể là 1 từ, 1 phần từ, hoặc 1 dấu câu.
Retrieval-Augmented Generation (RAG)
Cách phổ biến khi doanh nghiệp triển khai chatbot trên tài liệu nội bộ. Thay vì cố nhồi nhét một đống tài liệu vào prompt, flow của RAG như sau:
Câu hỏi → tìm tài liệu liên quan → lấy chính sách phù hợp → đưa cho LLM → LLM tạo câu trả lời.
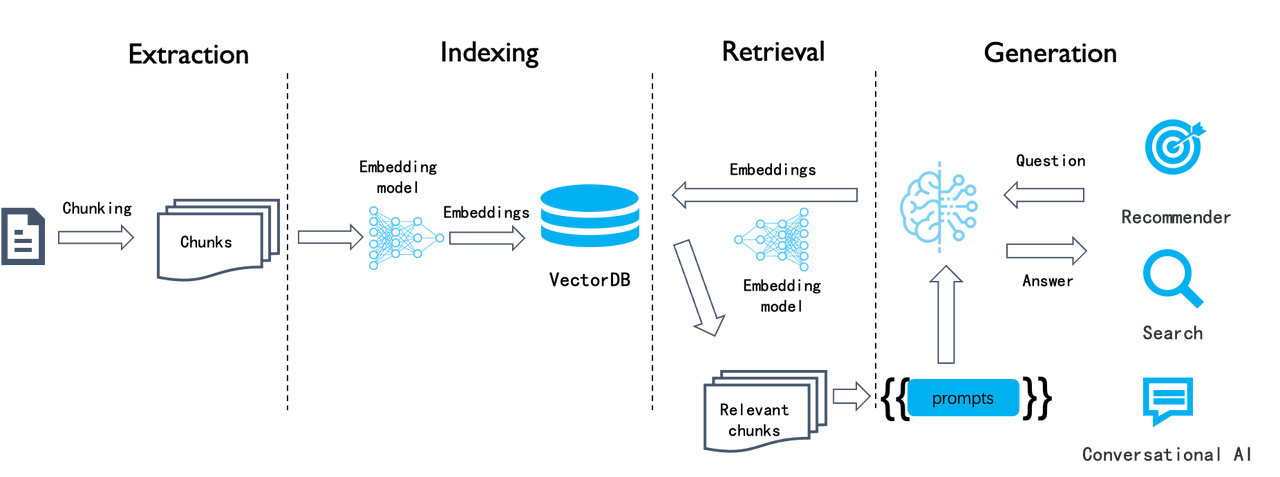
Điểm hay là khi tài liệu/chính sách thay đổi, doanh nghiệp chỉ cần cập nhật tài liệu thay vì retrain model. Nhược điểm nằm ở việc nếu chunk tài liệu không tốt thì LLM sẽ đưa kết quả sai.
Fine-tuning
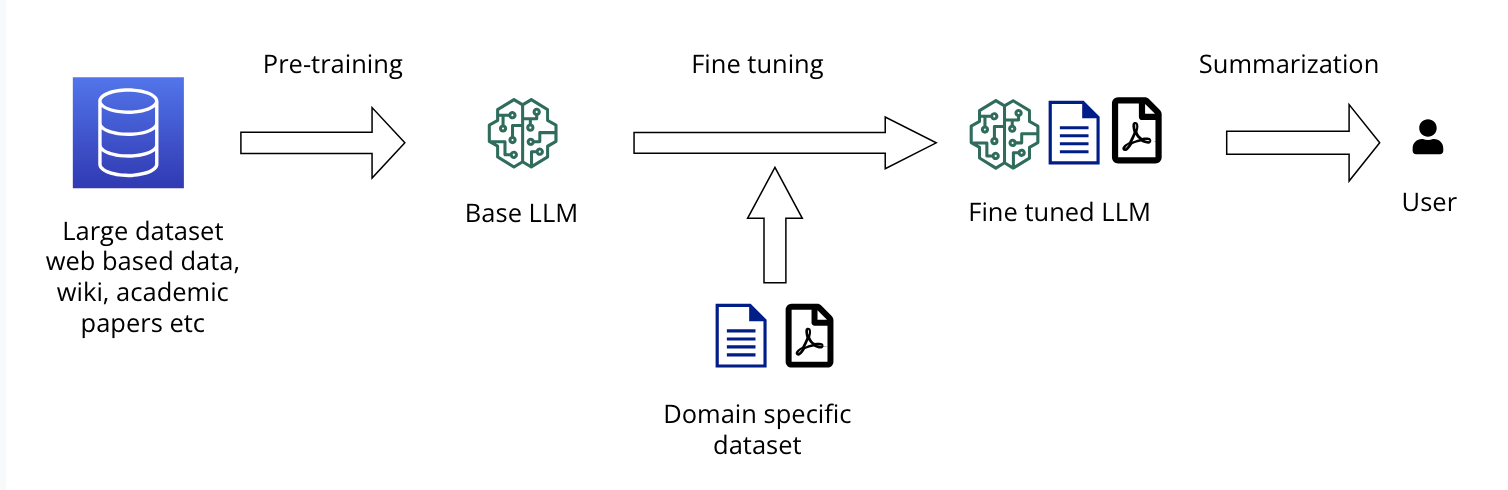
Nếu Prompt là hướng dẫn, RAG là cho AI tài liệu để đọc, thì Fine-tuning gần giống như đào tạo AI thành một người đã quen với công việc — không cần tra cứu, không cần ai hướng dẫn.
| Tiêu chí tối ưu hóa | Prompt Engineering | RAG | Fine-Tuning |
|---|---|---|---|
| Bản chất can thiệp | Điều chỉnh đầu vào (input) | Cung cấp ngữ cảnh thời gian thực | Cập nhật tham số mô hình (weights) |
| Chi phí / tài nguyên | Rất thấp (không cần hạ tầng riêng) | Trung bình (vector DB, pipeline) | Rất cao (GPU, chuyên gia MLOps) |
| Khả năng cập nhật | Tức thì, đổi lời nhắc | Linh hoạt qua database | Phức tạp, cần train và đánh giá lại |
| Mục tiêu ưu tiên | Thiết lập định dạng, kiểm tra nhanh | Độ chính xác thông tin, chống ảo giác | Chuyên môn hóa hành vi, đồng bộ giọng điệu |
| Độ trễ vận hành | Phụ thuộc độ dài prompt | Cao (cộng thêm thời gian truy xuất) | Thấp nhất (nếu model nhỏ, prompt ngắn) |
Chuẩn bị dữ liệu để training
Trước khi bàn tới các kỹ thuật fine-tuning, cần trả lời 3 câu hỏi về dữ liệu: cần loại data nào, cần bao nhiêu, và data phải trông như thế nào — vì kỹ thuật fine-tuning giỏi đến đâu cũng không cứu được một dataset chuẩn bị sai.
Fine-tuning cần loại data nào?
Model tốt đến đâu cũng khó cứu được một dataset tệ.
Nếu đưa cho model một tỷ ví dụ nhưng rất nhiều câu trả lời sai, format lộn xộn, model sẽ học luôn các thứ sai đó. Vì vậy trong Fine-tuning, chất lượng dữ liệu thường quan trọng không kém số lượng dữ liệu.
Bao nhiêu data là đủ?
Không có con số cố định cho mọi bài toán.
- Mục tiêu là thay đổi cách model trả lời → vài trăm đến vài nghìn sample là đủ thấy hiệu quả.
- Mục tiêu là để model quen với domain cụ thể (pháp lý, y khoa,…) → thường cần từ vài nghìn đến vài trăm nghìn sample.
Nhưng chốt lại: 1.000 mẫu tốt có thể có giá trị hơn 50.000 mẫu rác.
Data fine-tuning trông như thế nào?
Dữ liệu thường phải chuẩn hóa thành một format mà framework/model có thể hiểu. Có 2 format phổ biến: Alpaca-style và Chat/ShareGPT-style.
Alpaca — cách biểu diễn đơn giản, mỗi sample như một bài tập:
- Instruction: muốn model làm gì?
- Input: dữ liệu đầu vào là gì?
- Output: câu trả lời mong muốn là gì?
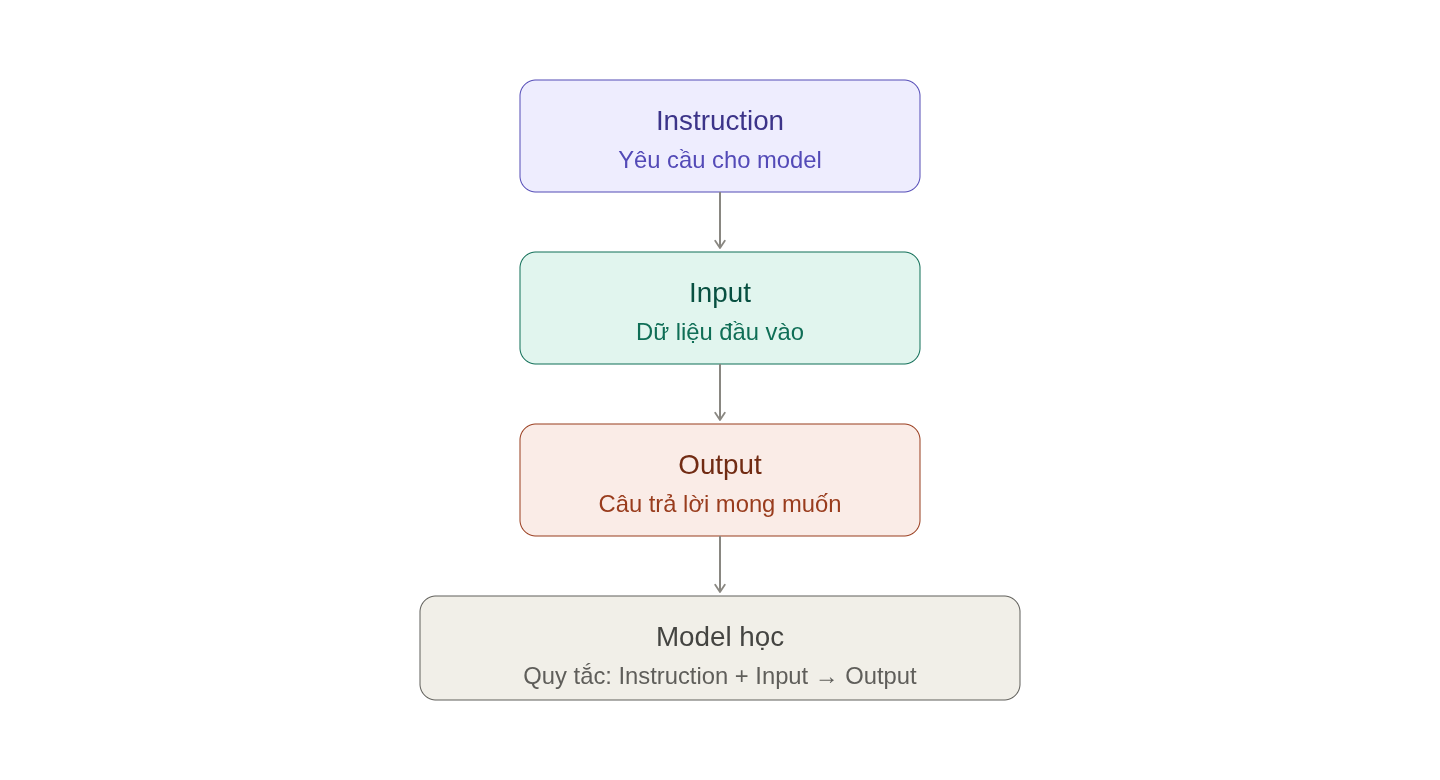
Ví dụ:
{
  "instruction": "Tóm tắt đoạn văn bản sau bằng một câu.",
  "input": "Hàng triệu năm trước, khủng long cai trị trái đất trước khi một thảm họa thiên thạch xảy ra...",
  "output": "Khủng long từng thống trị trái đất trước khi tuyệt chủng do thảm họa thiên thạch."
}
Phù hợp cho các task dạng input → output, ví dụ tóm tắt văn bản.
Chat/ShareGPT — LLM ngày nay không chỉ làm bài toán input-output, các chatbot phải trò chuyện qua nhiều turn:
System: Bạn là trợ lý chăm sóc khách hàng.
User: Internet nhà tôi bị chậm.
Assistant: Anh/chị có thể kiểm tra giúp em...
User: Tôi đã khởi động lại modem rồi.
Và assistant phải hiểu câu sau liên quan đến hội thoại trước. Với bài toán như vậy, format Chat/ShareGPT phù hợp hơn:
{
  "messages": [
    { "role": "system", "content": "Bạn là trợ lý chăm sóc khách hàng viễn thông." },
    { "role": "user", "content": "Internet nhà tôi bị chậm." },
    { "role": "assistant", "content": "Anh/chị có thể kiểm tra giúp em đèn Internet trên modem đang sáng hay đỏ không ạ?" }
  ]
}
Mỗi message có một role:
system: quy định AI phải hoạt động như thế nào.user: người dùng đang nói gì.assistant: câu trả lời mà model cần học.
Model không học từng câu riêng lẻ mà học cả một cuộc hội thoại diễn ra.
Chọn đúng format là một chuyện, nhưng khi ghép hàng loạt sample có độ dài khác nhau vào một batch để train, còn một vấn đề khác đang âm thầm ngốn compute: padding.
Padding Tax
Có cuộc hội thoại chỉ dài 100 token, có cuộc lại dài tới 3.000 token. Chuẩn hóa độ dài này như nào cho hợp lý?
Giả sử có 3 câu: A = 50 token, B = 100 token, C = 200 token. Khi đưa vào cùng một batch, Transformer thường cần các chuỗi có cùng kích thước, nên hệ thống lấy câu dài nhất làm chuẩn — cả A và B đều bị [PAD] thêm cho đủ 200 token.
Kết quả: thay vì xử lý 50 + 100 + 200 = 350 token, GPU phải xử lý 200 × 3 = 600 token. Đây chính là thứ người ta gọi vui là Padding Tax.
Vấn đề nghiêm trọng hơn khi train LLM, vì Attention có chi phí tăng rất nhanh theo độ dài sequence: sequence càng dài → tính toán càng tăng mạnh. Vậy nên dành nhiều compute chỉ để xử lý [PAD] là một sự lãng phí.
Note: Attention là cơ chế giúp mỗi token “nhìn” vào các token khác trong câu để hiểu ngữ cảnh.
Dynamic Batching
Ý tưởng: đừng xếp một câu 50 token chung với câu 2.000 token. Thay vào đó, gom từng câu có độ dài ngang nhau vào cùng batch — ví dụ batch gồm các câu 50-70 token, batch khác gồm các câu 850-1000 token.
Cách này dễ triển khai và ít padding hơn, nhưng padding vẫn tồn tại. Nếu dataset có độ dài rất khác nhau, GPU vẫn xử lý khá nhiều padding thừa.
Sequence Packing
Thay vì cố làm mọi sample dài bằng nhau, ta làm ngược lại: ghép nhiều sample ngắn vào cùng một sequence dài.
Ví dụ context window 1.000 token, với Sample A (300 token), B (400 token), C (250 token): thay vì mỗi sample kèm hàng trăm token PAD, ta ghép chúng lại thành A | B | C = 950 token, chỉ còn 50 token chưa dùng.
Phương pháp này hiệu quả trên dataset có nhiều sample ngắn, nhưng có một hạn chế cố hữu: nếu đơn giản nối A + B thành một sequence, Transformer có thể nhìn thấy toàn bộ sequence — token trong Sample A có khả năng “nhìn thấy” token trong Sample B thông qua Attention. Đây là điều không mong muốn, vì hai sample hoàn toàn độc lập về mặt logic. Hiện tượng này gọi là Information Contamination.
Không thể cứ nối tất cả sample lại với nhau rồi train như một sequence bình thường.
Block-Diagonal Attention
Giải pháp là dùng Attention Mask: dựng một “bức tường” giữa các sample trong cùng sequence.
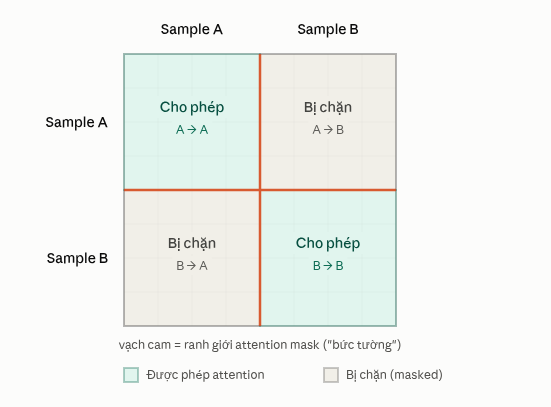
Token trong Sample A chỉ được Attention với token của A, token trong Sample B chỉ được Attention với token của B. Hai sample dùng chung một sequence vật lý nhưng về mặt logic vẫn hoàn toàn độc lập.
Còn Position thì sao?
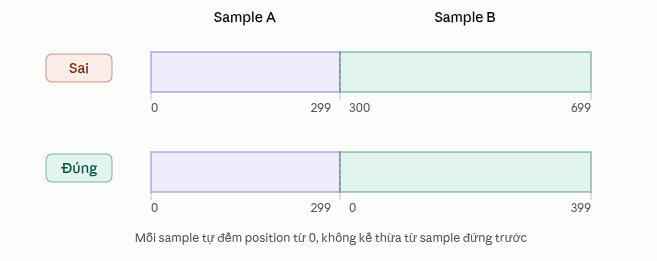
Nếu để position chạy liên tục (Sample A: 0→299, Sample B: 300→699), model có thể hiểu nhầm Sample B là phần tiếp nối của Sample A trong cùng một câu. Vì vậy, position index cũng được reset lại từ 0 cho mỗi sample, để mỗi sample vẫn giữ được “không gian vị trí” riêng.
VSL + Flash Attention
Thay vì tạo một tensor đầy [PAD], hệ thống có thể flatten toàn bộ token thành một chuỗi liên tục, đồng thời lưu thông tin điểm bắt đầu/kết thúc của từng sample (biểu diễn bằng cumulative sequence lengths).
Note: Flash Attention là kỹ thuật tính attention nhanh hơn và tốn ít bộ nhớ hơn cách tính thông thường, bằng cách xử lý theo từng khối nhỏ thay vì toàn bộ ma trận cùng lúc.
Flash Attention sau đó biết: “đoạn 0–300 là sample A, đoạn 300–700 là sample B, đoạn 700–950 là sample C.”
Đến đây, ta đã giải quyết một phần bài toán Fine-tuning:
- Dataset phải đủ tốt.
- Dữ liệu phải có format phù hợp.
- Batch cần được đóng gói hiệu quả.
- Padding cần được hạn chế để GPU không lãng phí compute.
Coi như xong phần chuẩn bị dữ liệu. Phần tiếp theo mới là trọng tâm của bài: các phương pháp fine-tuning phổ biến, bắt đầu từ cách truyền thống nhất rồi đi dần tới các kỹ thuật tiết kiệm tài nguyên hơn.
Full Fine-tuning
Cách truyền thống là Full Fine-Tuning (FFT): model có bao nhiêu tham số thì training cập nhật bấy nhiêu tham số.
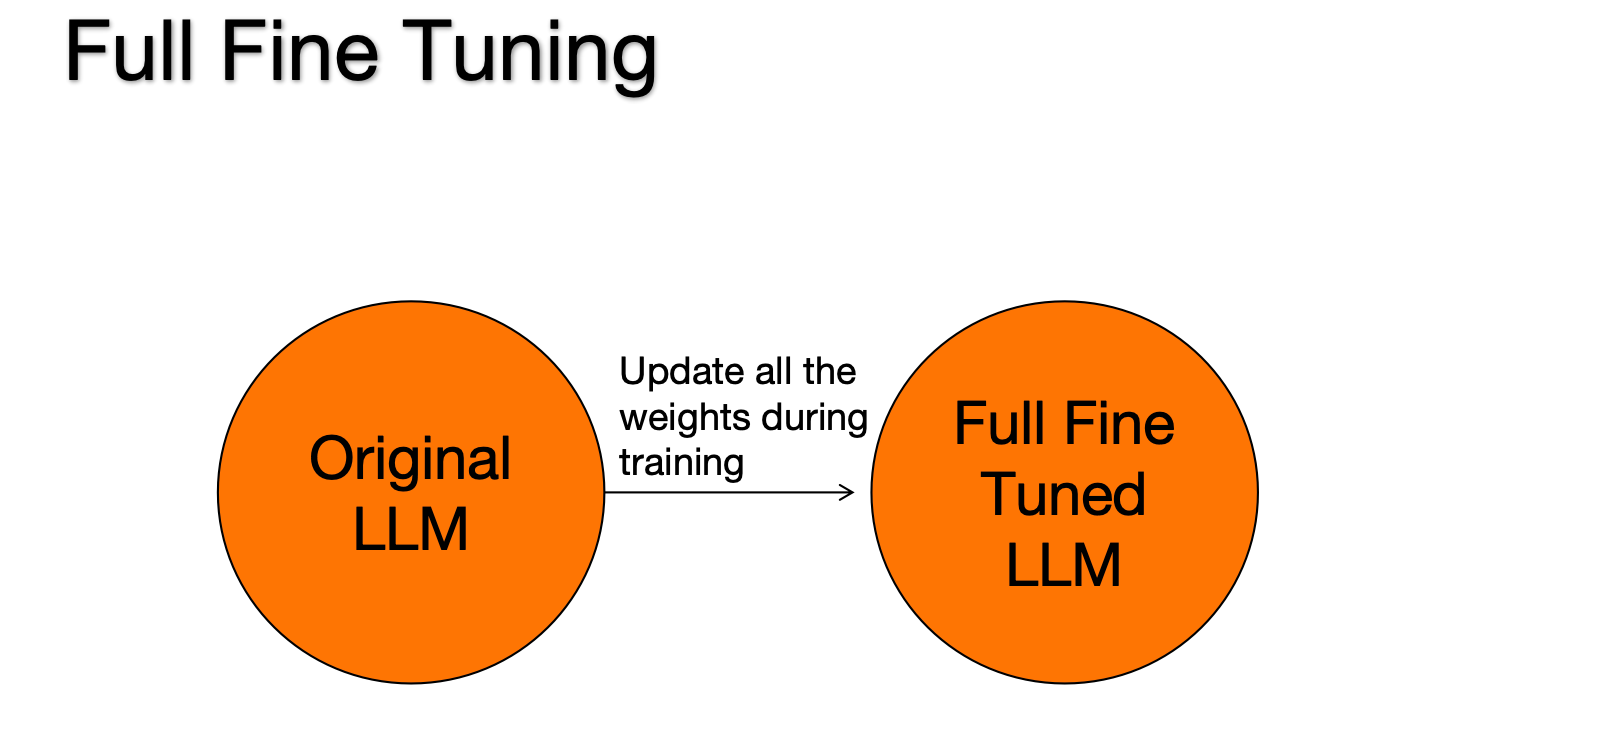
Ví dụ một model 7 tỷ parameters, cả 7 tỷ đều có thể được cập nhật qua backpropagation.
Note: Backpropagation là quá trình model tự điều chỉnh trọng số sau mỗi lần đoán sai, bằng cách lan truyền ngược lỗi từ output về từng tham số.
Vấn đề: 7 tỷ tham số không chỉ tốn bộ nhớ để lưu weights. Trong quá trình training, GPU còn phải lưu thêm gradients, optimizer states, activation, và nhiều buffer trung gian khác. Vì vậy một model “chỉ 7B” có thể cần lượng VRAM lớn hơn rất nhiều so với việc chỉ chạy inference.
Chạy một LLM và Fine-tune một LLM là hai câu chuyện hoàn toàn khác nhau về yêu cầu phần cứng.
Với các model hàng chục hoặc hàng trăm tỷ tham số, Full Fine-tuning nhanh chóng trở thành bài toán hạ tầng rất đắt đỏ. Thay vì thay đổi cả model, tại sao không chỉ thay đổi một phần rất nhỏ? Đó chính là ý tưởng của PEFT.
Parameter-Efficient Fine-Tuning (PEFT)
Ý tưởng rất đơn giản: đóng băng model gốc và chỉ train thêm một lượng nhỏ parameters.
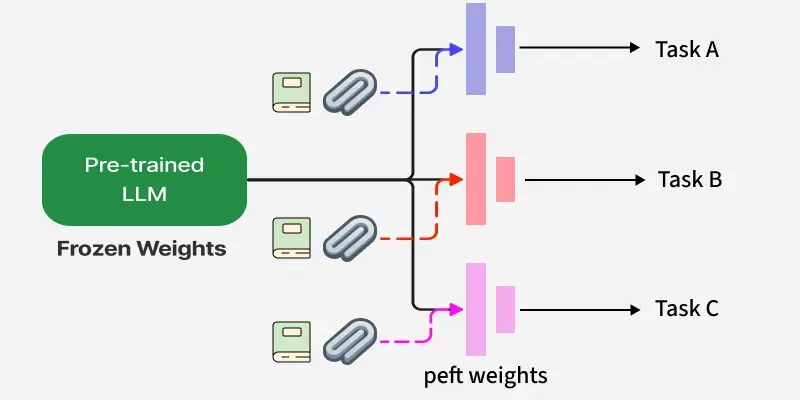
Hãy tưởng tượng base model là một nhân viên đã có rất nhiều kiến thức. Nếu muốn nhân viên này làm thêm một công việc mới, không nhất thiết phải “cho học lại toàn bộ kiến thức từ đầu” — có thể giữ nguyên kiến thức cũ và chỉ đào tạo thêm một module chuyên môn.
Đây là lý do PEFT tiết kiệm đáng kể VRAM, compute, thời gian training, storage và chi phí triển khai. Trong số các phương pháp PEFT, cái tên nổi bật nhất là LoRA – Low-Rank Adaptation.
LoRA
Hãy tưởng tượng một layer của model có một ma trận trọng số cực kỳ lớn. Trong Full Fine-tuning, ta học toàn bộ thay đổi $W \to W + \Delta W$, tức model phải học một ma trận $\Delta W$ khổng lồ.
LoRA đặt câu hỏi: liệu có cần học toàn bộ $\Delta W$ không? Câu trả lời là không nhất thiết. LoRA giả định phần thay đổi cần thiết cho một task cụ thể có thể được biểu diễn bằng một không gian nhỏ hơn rất nhiều. Thay vì học trực tiếp $\Delta W$, LoRA tách nó thành hai ma trận nhỏ:
$$\Delta W \approx B \cdot A$$$$W_{new} = W + B \cdot A$$với rank $r$ nhỏ hơn rất nhiều so với kích thước ma trận ban đầu.
Nhưng paper LoRA gốc (Hu et al., 2021, arXiv:2106.09685) đặt bài toán tổng quát hơn:
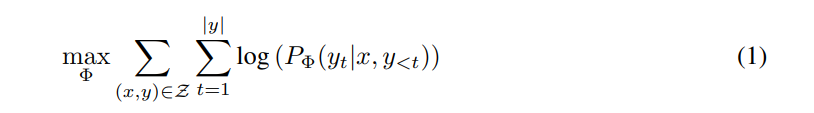
với $\Phi$ được khởi tạo từ $\Phi_0$ (pretrained) và cập nhật thành $\Phi_0 + \Delta\Phi$, nhưng $|\Delta\Phi| = |\Phi_0|$ — đây chính là lý do FFT tốn kém: GPT-3 có $|\Phi_0| \approx 175$ tỷ thì $\Delta\Phi$ cũng lớn tương đương.
LoRA thay bằng: mã hóa $\Delta\Phi = \Delta\Phi(\Theta)$ qua một tập tham số $\Theta$ nhỏ hơn nhiều ($|\Theta| \ll |\Phi_0|$), bài toán tối ưu trở thành:
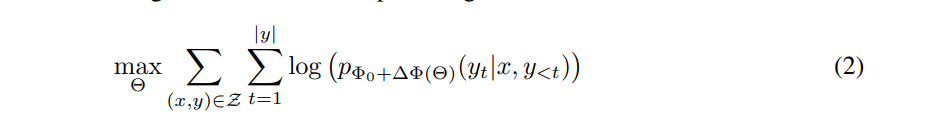
Với GPT-3 175B, $|\Theta|$ có thể nhỏ tới 0.01% của $|\Phi_0|$ — đây chính là ý nghĩa của cụm “adapter nhỏ” sẽ được nhắc lại xuyên suốt phần sau.
Trước LoRA, người ta đã thử gì?
LoRA không phải ý tưởng PEFT đầu tiên. Trước đó có hai hướng chính, cả hai đều có vấn đề khiến LoRA ra đời.
Adapter layer — chèn thêm vài lớp nhỏ xen giữa các layer gốc của Transformer. Vấn đề: các lớp này phải chạy tuần tự, không thể song song hóa. Dù adapter rất nhẹ (đôi khi <1% tham số), việc bắt GPU chạy thêm một bước tính toán nối tiếp vẫn cộng dồn thành latency thật khi inference (đo trên GPT-2 medium với batch size = 1, tình huống inference online phục vụ từng request một).
Prefix-tuning — không đụng vào weight, mà tối ưu trực tiếp một số token đặc biệt chèn vào đầu input. Vấn đề: khó optimize (hiệu năng không tăng đều khi tăng số token), và các token này chiếm luôn một phần context window vốn dành cho nội dung thật của task.
Đây là lý do LoRA chọn thiết kế khác hẳn: cộng song song vào weight gốc ($W + BA$) thay vì chèn nối tiếp như Adapter, và sau khi train xong có thể merge thẳng $BA$ vào $W$ — nên không tốn thêm latency lúc inference, không đụng vào context window lúc train.
Nói dân dã:
Full Fine-tuning: sửa cả bức tường. LoRA: giữ nguyên bức tường, chỉ gắn thêm một tấm bảng nhỏ lên đó.
Tấm bảng này chính là LoRA adapter.
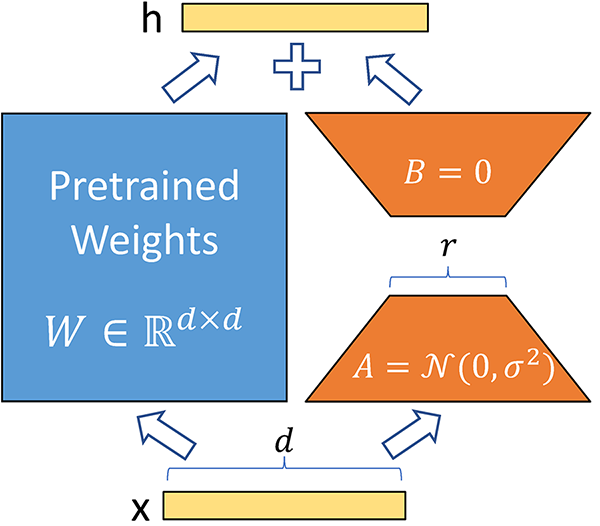
Nhìn hình trên dễ thắc mắc: tại sao khởi tạo $A \sim \mathcal{N}(0, \sigma^2)$, $B = 0$? Tại sao không phải ngược lại? Tại sao không phải cả 2 bằng 0?
Đây không phải lựa chọn tùy ý:
- Nếu cả $A$ và $B$ đều $= 0$ → gradient của $A$ cũng bằng 0 tại bước đầu (vì $\partial L / \partial A$ phụ thuộc vào $B$), model “chết”, không học được gì.
- Nếu cả $A$ và $B$ đều random → $\Delta W = BA \neq 0$ ngay từ đầu → model xuất phát từ một điểm lệch khỏi pretrained weights một cách ngẫu nhiên, có thể phá vỡ hành vi đã học trước khi adapter kịp học điều gì có ích.
- Chọn $B = 0$, $A$ random → $\Delta W = BA = 0$ chính xác tại bước 0 (vì bất kỳ số nào nhân với ma trận 0 đều ra 0), nhưng gradient của $B$ vẫn khác 0 (vì phụ thuộc vào $A$ đã có giá trị random) → training bắt đầu, mà model vẫn xuất phát y hệt pretrained.
Nói cách khác: $B = 0$ đảm bảo “điểm xuất phát an toàn”, còn $A$ random đảm bảo “có tín hiệu để học”.
Vì sao một adapter nhỏ lại đủ?
Một LLM có thể có hàng tỷ tham số, nhưng khi chuyển từ task này sang task khác, không phải toàn bộ kiến thức của model đều cần thay đổi. Ví dụ base model đã biết tiếng Việt, tiếng Anh, kiến thức phổ thông, cách lập luận, cách viết câu, kiến thức lập trình. Nếu muốn nó trở thành “trợ lý phân loại cuộc gọi khách hàng viễn thông”, không cần dạy lại toàn bộ những thứ trên — chỉ cần model học thêm những pattern đặc thù của task.
LoRA cố gắng lưu phần thay đổi đó vào một tập tham số nhỏ hơn rất nhiều. Kết quả: thay vì lưu một bản model hàng chục GB cho mỗi task, ta có thể giữ một base model duy nhất kết hợp với nhiều adapter khác nhau.
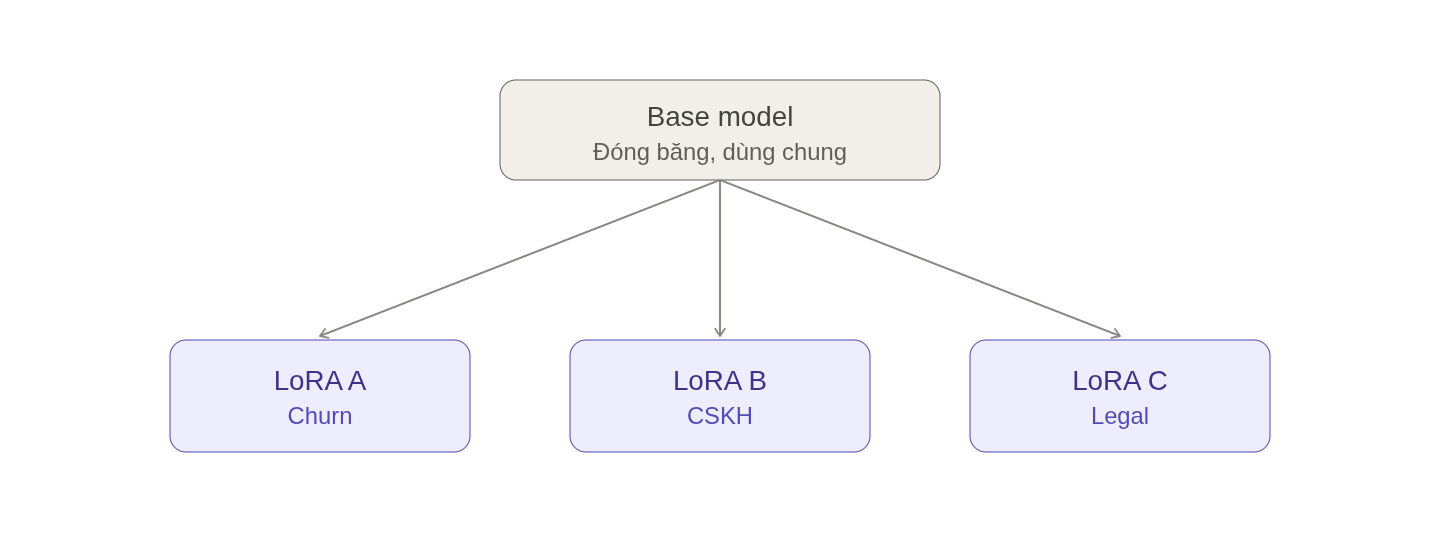
Một hyperparameter quan trọng của LoRA là rank r — mức độ “dung lượng” mà adapter được phép sử dụng để học task mới.
r nhỏ → adapter nhỏ → ít tham số → train nhanh hơn → nhưng khả năng biểu diễn hạn chế hơn
r lớn → adapter lớn → nhiều tham số hơn → học pattern phức tạp hơn → nhưng tốn compute và memory hơn
Ví dụ thường gặp: r = 8, 16, 32, 64. Không có một giá trị r đúng cho mọi bài toán — task đơn giản thì rank nhỏ có thể đã đủ, task phức tạp hoặc data lớn có thể cần rank cao hơn.
Rank là một trade-off giữa năng lực biểu diễn và chi phí.
Hyperparameter khác là alpha ($\alpha$) — nếu rank quyết định adapter “học được bao nhiêu”, alpha là mức độ ảnh hưởng của adapter lên model gốc:
$$W_{new} = W + \frac{\alpha}{r} \cdot BA$$$\alpha/r$ quyết định mức scale của phần cập nhật LoRA. Ví dụ $r = 16, \alpha = 32 \Rightarrow \alpha/r = 2$.
Paper LoRA gốc mô tả: sau khi chọn một giá trị $r$ để thử nghiệm đầu tiên, họ set α bằng đúng con số r đó, rồi giữ nguyên α không đổi kể cả khi thử các giá trị $r$ khác nhau — tức α là hằng số cố định, không tự động scale theo r mỗi lần đổi rank. Lý do: khi optimize bằng Adam, việc tune α gần tương đương tune learning rate (cả hai đều chỉ scale độ lớn bước cập nhật), nên thay vì grid-search cả α lẫn r cùng lúc, họ cố định α để giảm số hyperparameter cần tune.
Nhưng các blog/tutorial khác (từ 2023 trở đi) lại đi ngược lại với LoRA gốc: cộng đồng dùng rule of thumb $\alpha = 2r$ — để tỷ lệ $\alpha/r$ cố định (=2) mỗi khi đổi r, chứ không giữ α cố định như paper gốc. Đây không phải sai lầm ngẫu nhiên — hai paper sau này (Kalajdzievski 2023, và Biderman et al. 2024 trong “LoRA vs Full Fine-tuning: An Illusion of Equivalence”) chỉ ra: nếu giữ α cố định trong khi tăng r, effective rank của update matrix bị “sụp” xuống mức thấp hơn nhiều so với r cho phép — tăng r mà không tăng α theo tỷ lệ sẽ lãng phí, model không tận dụng được rank cao hơn đã trả tiền cho nó.
Gắn LoRA vào đâu?
Transformer có rất nhiều layer, không nhất thiết LoRA phải gắn vào tất cả. Có thể chỉ định những module muốn train, chẳng hạn các projection trong Attention (q_proj, k_proj, v_proj, o_proj), hoặc mở rộng sang nhiều linear layer hơn.
Gắn ít → nhẹ hơn nhưng có thể hạn chế khả năng học. Gắn nhiều → nhiều tham số hơn nhưng có thể đạt hiệu quả tốt hơn. Khi cấu hình LoRA, ta thường cân nhắc ít nhất ba thứ: rank (adapter lớn đến đâu), alpha (adapter ảnh hưởng mạnh đến đâu), và target modules (adapter gắn vào đâu).
Có một cách nhìn gọn để hiểu vì sao LoRA “gần” với FFT hơn Adapter hay Prefix-tuning: nếu áp LoRA vào toàn bộ các ma trận trọng số và cho phép r lớn bằng đúng rank thật của ma trận pretrained, về mặt lý thuyết LoRA sẽ hội tụ về chính xác Full Fine-tuning. Trong khi đó, càng tăng tham số, Adapter chỉ hội tụ về một MLP giới hạn, còn Prefix-tuning bị chặn bởi độ dài context có thể dùng.
Nhưng vẫn còn một thứ chiếm rất nhiều VRAM: base model. Trong LoRA, phần lớn trọng số model gốc vẫn được giữ nguyên và đóng băng — nhưng “không train” không có nghĩa “không cần lưu”. Nếu model có hàng chục tỷ tham số, vẫn phải đưa toàn bộ trọng số đó vào GPU để thực hiện forward pass.
Câu hỏi tiếp theo rất tự nhiên: nếu không cần cập nhật các trọng số này, liệu có cần lưu chúng ở độ chính xác cao như vậy không? Câu trả lời: không nhất thiết. Đây chính là ý tưởng đằng sau QLoRA – Quantized LoRA.
QLoRA
QLoRA (Dettmers et al., NeurIPS 2023, arXiv:2305.14314) đặt lại câu hỏi ở phần trước. Thay vì lưu base model ở FP16 hoặc BF16, QLoRA lượng tử hóa (quantize) trọng số của model xuống 4-bit. Trong khi đó, phần LoRA adapter vẫn được train ở độ chính xác cao hơn, thường là FP16/BF16.
Base Model      → quantize xuống 4-bit → giữ nguyên, không train
LoRA Adapter    → FP16 / BF16          → train bình thường
Ý tưởng khá đẹp: không cần giảm độ chính xác của thứ đang học nhiều, chỉ cần giảm độ chính xác của phần đang được đóng băng.
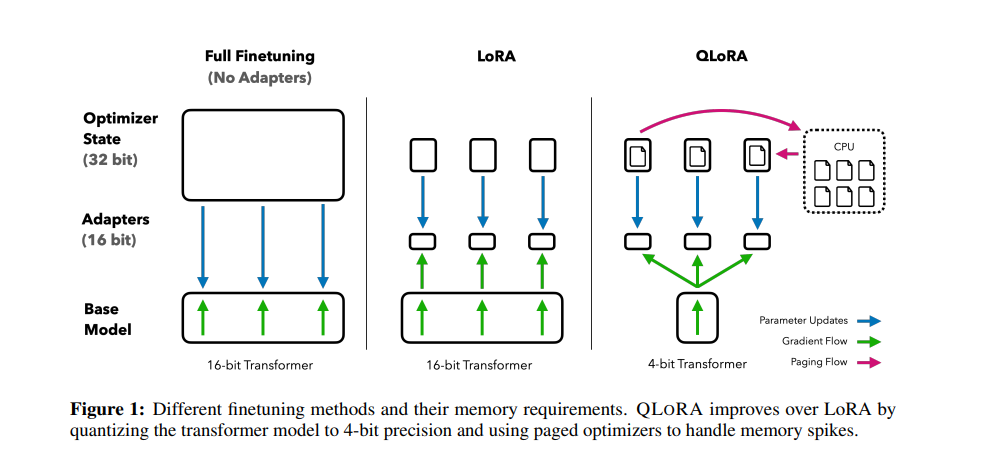
Liệu 4-bit có làm model “kém” đi không? Về mặt logic, nhiều người sẽ nghĩ “từ 16-bit xuống 4-bit thì mất 75% thông tin, model chắc phải kém đi rất nhiều?” Nhưng không đơn giản như vậy — quantize không phải tùy tiện vứt bỏ bit, mà tìm cách biểu diễn trọng số bằng ít bit hơn nhưng giữ lại thông tin quan trọng nhất. QLoRA đưa ra một số kỹ thuật để làm việc này hiệu quả hơn, điển hình là NF4.
NF4 – 4-bit
Một thành phần quan trọng của QLoRA là NormalFloat4 (NF4), dựa trên fact: “trọng số của neural network thường có phân phối gần với phân phối chuẩn”. Có 3 cách giải thích cho việc này:
(1) Khởi tạo. Ngay từ đầu, weights thường được lấy từ Gaussian — các cách khởi tạo phổ biến như Xavier/Glorot và He initialization thường lấy weight từ một phân phối đối xứng quanh 0, thường là Gaussian hoặc uniform với variance được kiểm soát.
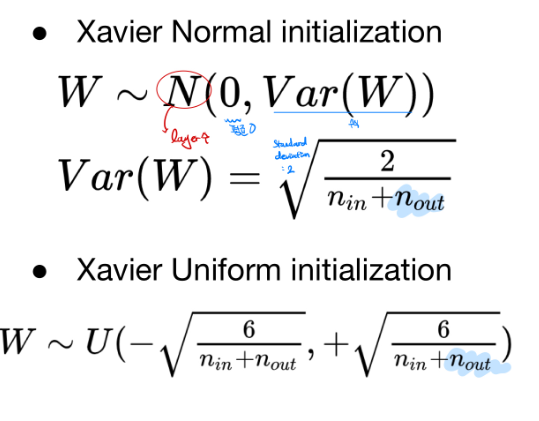
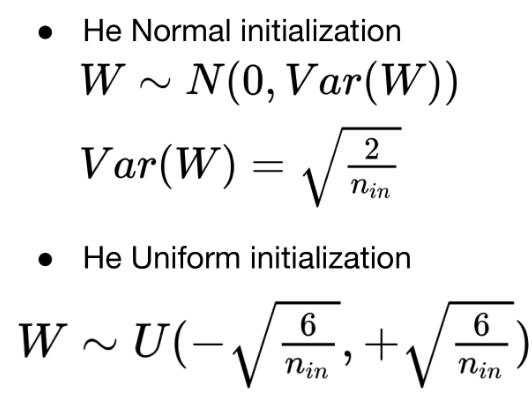
Mục đích không phải để đẹp, mà tránh activation và gradient bị quá lớn dẫn tới exploding, hoặc quá nhỏ dẫn tới vanishing.
(2) Neural network có rất nhiều phép cộng. Một neuron thường tính tổng của trọng số nhân với đặc trưng:
$$z = \sum_{i=1}^{n} w_i x_i$$Theo định lý giới hạn trung tâm (Central Limit Theorem), dưới một số điều kiện nhất định, tổng của một số lượng lớn các biến ngẫu nhiên độc lập sẽ có phân phối tiến gần phân phối chuẩn sau khi chuẩn hóa.
(3) Training thường không phá vỡ hoàn toàn cấu trúc. Trong quá trình backpropagation:
$$W_{new} = W - \eta \nabla W$$weights liên tục bị điều chỉnh, nhưng với các optimizer và regularization thông thường, phần lớn weights vẫn quanh một vùng trung tâm — distribution vẫn có hình dạng tương đối “chuông”, dù không nhất thiết là Gaussian chuẩn.
Quay lại NF4: nếu weights xấp xỉ phân phối chuẩn, hãy chọn 16 giá trị đại diện sao cho phù hợp với phân phối đó, thay vì chia khoảng giá trị thành các đoạn bằng nhau. Phần lớn weights nằm gần 0 → cần biểu diễn vùng này chi tiết hơn. Các giá trị cực lớn/nhỏ xuất hiện ít → không cần dành quá nhiều mức lượng tử hóa cho chúng.
Khi lượng tử hóa trọng số, ta cần thêm một số quantization constants/scales để biết cách chuyển đổi giữa giá trị gốc và giá trị đã lượng tử hóa — nhưng các constants này cũng chiếm bộ nhớ. QLoRA đặt câu hỏi: nếu đã tiết kiệm bộ nhớ cho weights, tại sao không tiết kiệm tiếp ở phần metadata này? Đó chính là Double Quantization.
Double Quantization
Thông thường ta chỉ quantize weights một lần. QLoRA quantize thêm cả quantization constants:
Weights → quantize
Quantization Constants → quantize tiếp
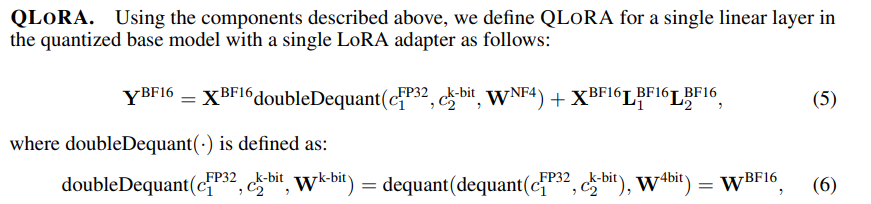
Ví dụ, giả sử chia weights thành các block 64 phần tử. Với mỗi block, cần một scale/quantization constant để đưa các giá trị 4-bit trở lại gần giá trị gốc. Nếu scale được lưu bằng FP32, riêng scale đã tốn 32 bits / 64 weights = 0.5 bits/parameter. Nghe có vẻ nhỏ, nhưng với hàng chục tỷ parameters thì 0.5 bit/parameter trở thành một lượng bộ nhớ đáng kể.
QLoRA nhận ra các scale này lại là một tập số có thể quantize lần nữa — thay vì scale bằng FP32, quantize xuống 8-bit scales. Nhưng lại xuất hiện vấn đề nhỏ: muốn giải mã 8-bit scales thì cũng cần một scale để giải mã chúng. Vì vậy ta có một cấu trúc hai tầng:
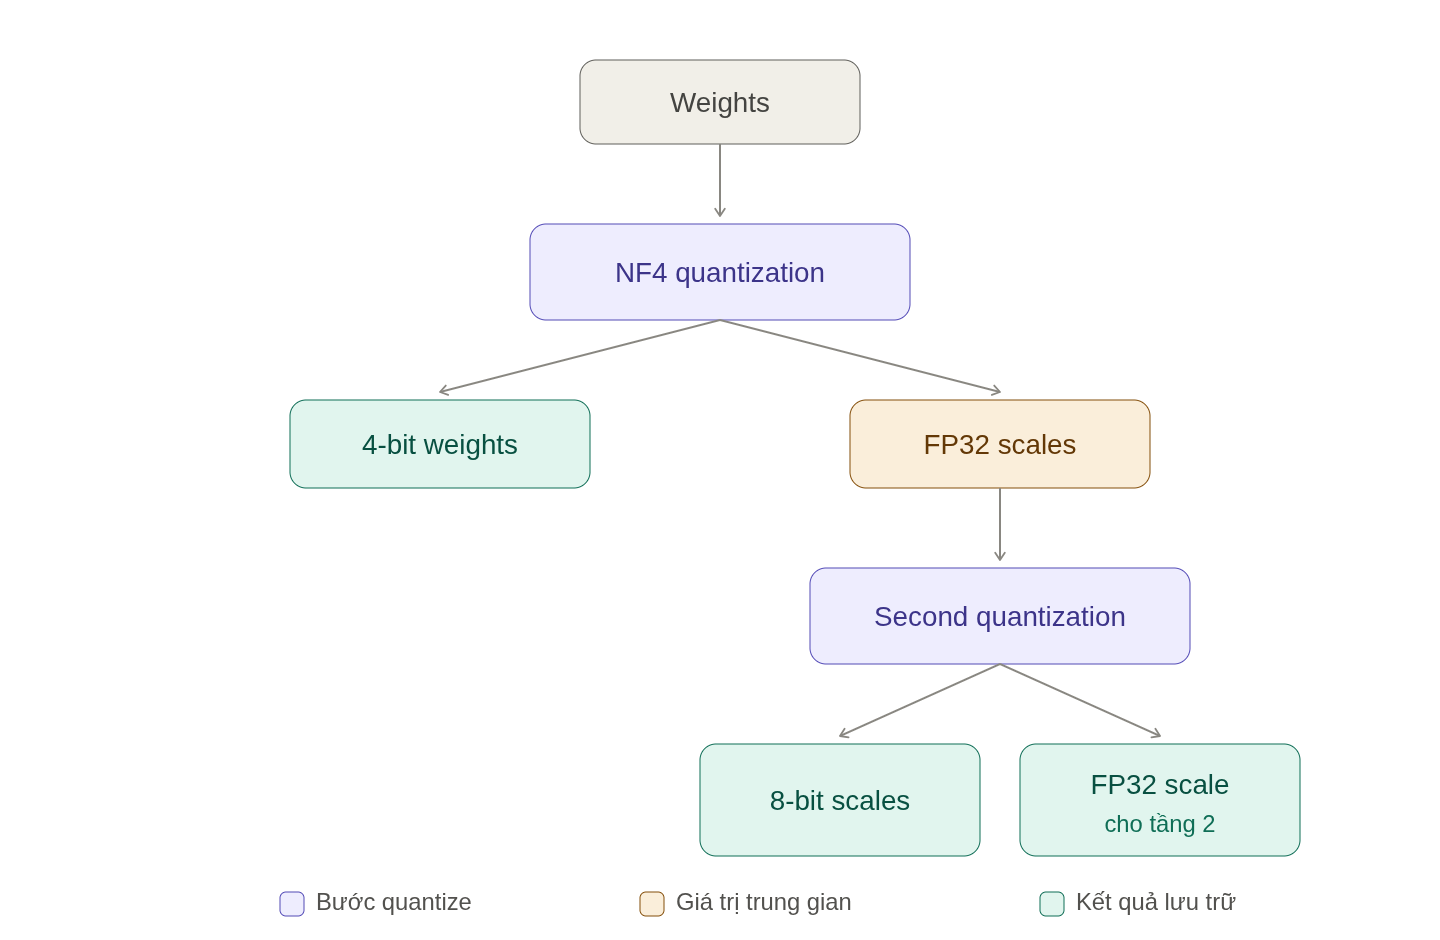
Theo QLoRA, với block size 64 ở tầng đầu và lượng tử hóa constants ở tầng thứ hai, overhead của quantization constants giảm từ 0.5 bits/parameter xuống khoảng 0.127 bits/parameter, tiết kiệm khoảng 0.373 bits/parameter.
Paged Optimizer
Dù đã giảm đáng kể memory của weights và quantization constants, quá trình training vẫn còn vấn đề khác: memory không phải lúc nào cũng ổn định. Trong quá trình forward → backward → optimizer update, GPU memory có thể xuất hiện những spike tạm thời. Với các model lớn, chỉ cần một peak vượt VRAM khả dụng cũng có thể khiến training gặp Out-of-Memory (OOM).
Đây là vấn đề mà Paged Optimizer của QLoRA giải quyết — tận dụng CUDA Unified Memory để cho phép memory được quản lý giữa GPU và CPU. Khi GPU không đủ memory, các page memory có thể được chuyển từ GPU sang CPU thay vì lập tức gây OOM.
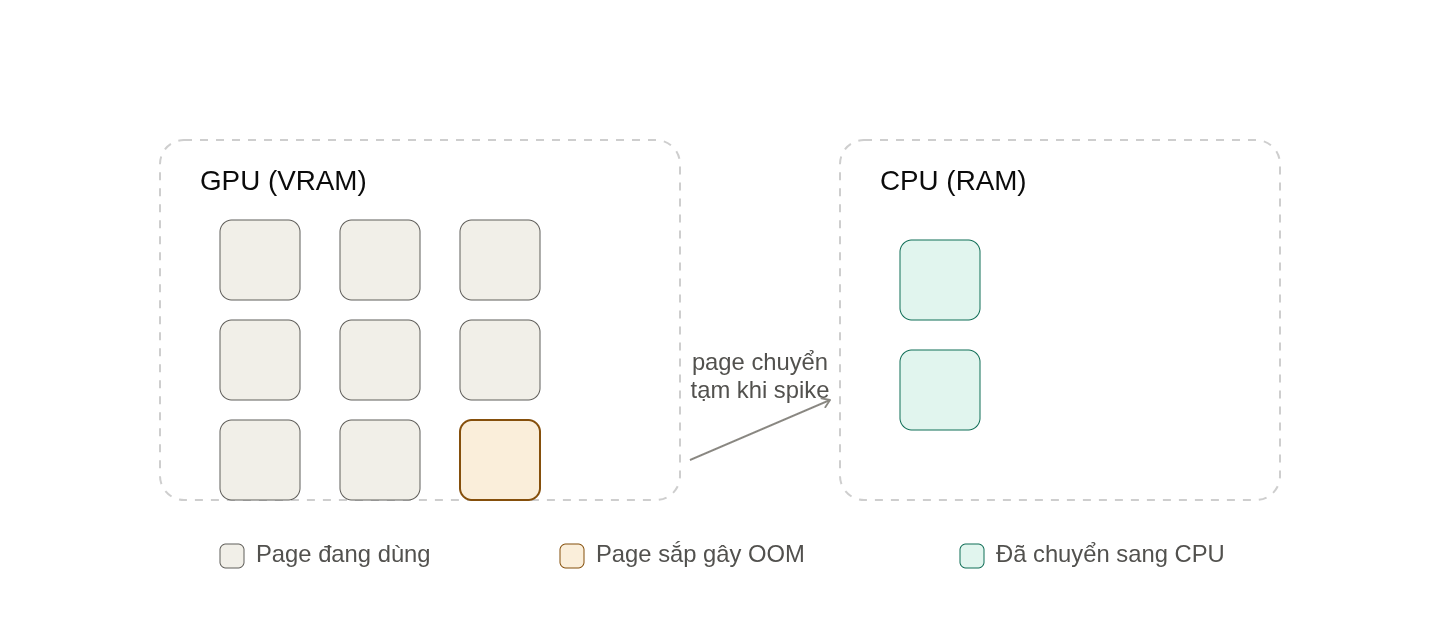
Đến đây, QLoRA đã giải quyết một trong những nút thắt lớn nhất của Fine-Tuning LLM: memory. Thay vì lưu toàn bộ pretrained weights ở FP16, QLoRA đưa chúng xuống 4-bit bằng NF4, tiếp tục nén quantization constants bằng Double Quantization, đồng thời dùng Paged Optimizer để xử lý memory spike trong training.
QLoRA giúp train một model lớn với ít memory hơn, nhưng bản chất của adapter vẫn là LoRA. Và LoRA vẫn tồn tại một vấn đề: hiệu năng đôi khi còn khoảng cách so với Full Fine-Tuning, đặc biệt trên những tác vụ khó. Đây chính là câu hỏi mà nghiên cứu tiếp theo bắt đầu đào sâu — điểm chuyển tự nhiên từ QLoRA → DoRA.
DoRA
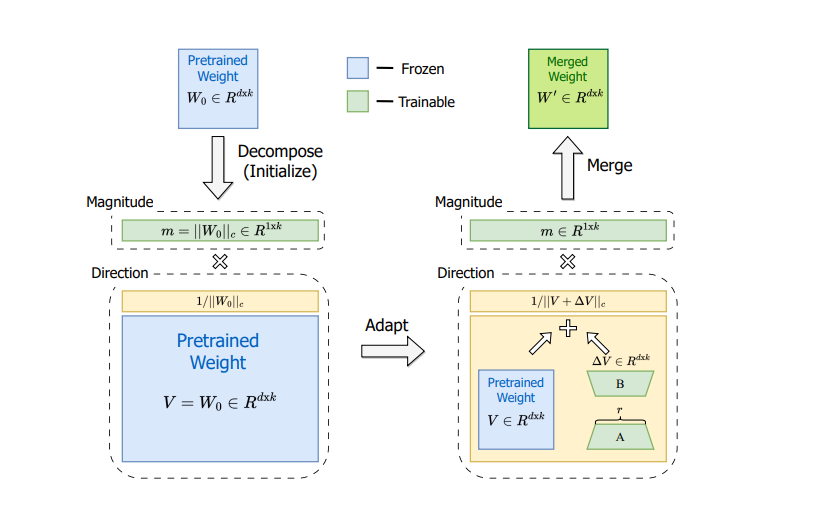
Trong FFT, việc cập nhật tham số có mức độ tự do rất cao — model có thể thay đổi mạnh về hướng (direction) trong khi gần như giữ nguyên độ lớn (magnitude), hoặc ngược lại. Nhưng vì LoRA gộp cả hai chiều này vào chung một ma trận hạng thấp $\Delta W \approx BA$, nó vô tình trói buộc magnitude và direction lại với nhau, không phản ánh đúng hành vi học của FFT.
Năm 2024, nhóm NVIDIA (Liu et al., ICML 2024 Oral, arXiv:2402.09353) đề xuất DoRA (Weight-Decomposed Low-Rank Adaptation), tách trọng số tiền huấn luyện $W$ thành một vector độ lớn $m$ và ma trận hướng $V / \lVert V \rVert_c$ độc lập:
$$W = m \cdot \frac{V}{\lVert V \rVert_c}$$Trong đó $m$ (số tham số rất nhỏ) được update trực tiếp bằng gradient descent, còn $V$ (ma trận lớn) vẫn được cập nhật qua low-rank adaptation kiểu LoRA ($V + BA$). Nhờ tách riêng hai chiều tự do này, DoRA bắt chước sát hơn hành vi học của FFT.
Nhìn lại: khi nào dùng cái gì?
| Kỹ thuật | Base model | VRAM cần | Chất lượng | Khi nào dùng |
|---|---|---|---|---|
| Full Fine-tuning | Train toàn bộ | Rất cao | Cao nhất (baseline) | Đủ GPU, cần hiệu năng tối đa, task khó |
| LoRA | Đóng băng, FP16/BF16 | Trung bình | Gần FFT ở hầu hết task | Muốn train nhanh, giữ nhiều adapter cho nhiều task |
| QLoRA | Đóng băng, quantize 4-bit (NF4) | Thấp | Gần LoRA, đôi khi giảm nhẹ | GPU hạn chế VRAM, cần fine-tune model lớn trên phần cứng nhỏ |
| DoRA | Đóng băng, tách magnitude/direction | Tương đương LoRA | Sát FFT hơn LoRA ở cùng số tham số | Cần chất lượng cao hơn LoRA mà chưa đủ tài nguyên cho FFT |
Kết luận
PEFT là mảng đang tiến rất nhanh. Chỉ tính riêng 2025–2026, hàng loạt variant đã công bố vượt DoRA trên cùng bộ benchmark commonsense reasoning: CORA, BaLoRA, ALLoRA, Echo-LoRA, và LoFT (paper 2026 báo cáo cải thiện tới +40% so với DoRA trên cùng thiết lập). Phần lớn các con số này là self-reported bởi chính nhóm đề xuất phương pháp, chưa có nhiều đánh giá độc lập rộng rãi — nên xem DoRA/QDoRA là một cột mốc quan trọng (đã được validate qua ICML 2024 Oral + triển khai thực tế trong Hugging Face PEFT), chứ không phải điểm dừng cuối cùng của PEFT.