Nguồn gốc & lịch sử
Nếu nhìn lại quá trình phát triển của AI vài năm qua, bạn sẽ thấy một sự tiến hóa kiến trúc đáng kinh ngạc. Chỉ mới 2022–2024, tất cả chúng ta còn đang chật vật với nghệ thuật “múa phím” bằng prompt engineering, chúng ta đã tiến rất nhanh sang việc tối ưu ngữ cảnh (context engineering) và tích hợp công cụ (tool use). Không dừng lại ở đó, giới kỹ sư tiếp tục nhúng AI vào các vòng lặp tự trị (autonomous loops), xây dựng hệ thống trí nhớ dài hạn và thiết lập các tổ chức đa tác tử (multi-agent orchestration) phức tạp.
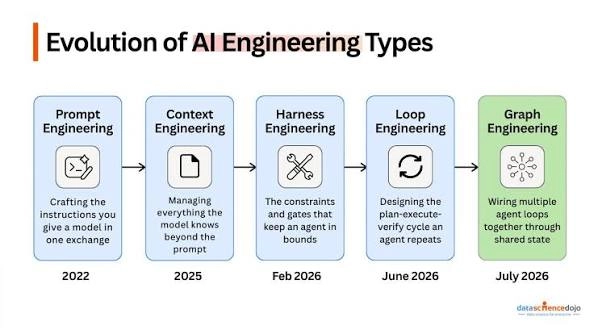 Dòng thời gian tiến hóa của các phương pháp kỹ thuật AI, từ Prompt Engineering (2022) đến Graph Engineering (2026).
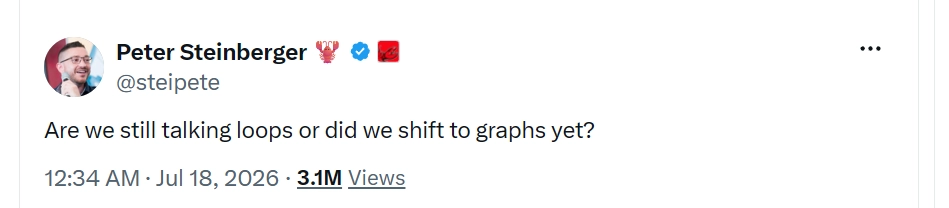
Vào giữa năm 2026, Peter Steinberger (founder OpenClaw) đã hỏi một câu hỏi tưởng chừng vu vơ trên X nhưng trở nên viral: “Chúng ta vẫn đang nói về vòng lặp (loops) hay đã chuyển sang đồ thị (graphs) rồi?”
 Vài giờ sau, kỹ sư AI nổi tiếng Hamel Husain đưa ra một khẳng định xanh rờn:
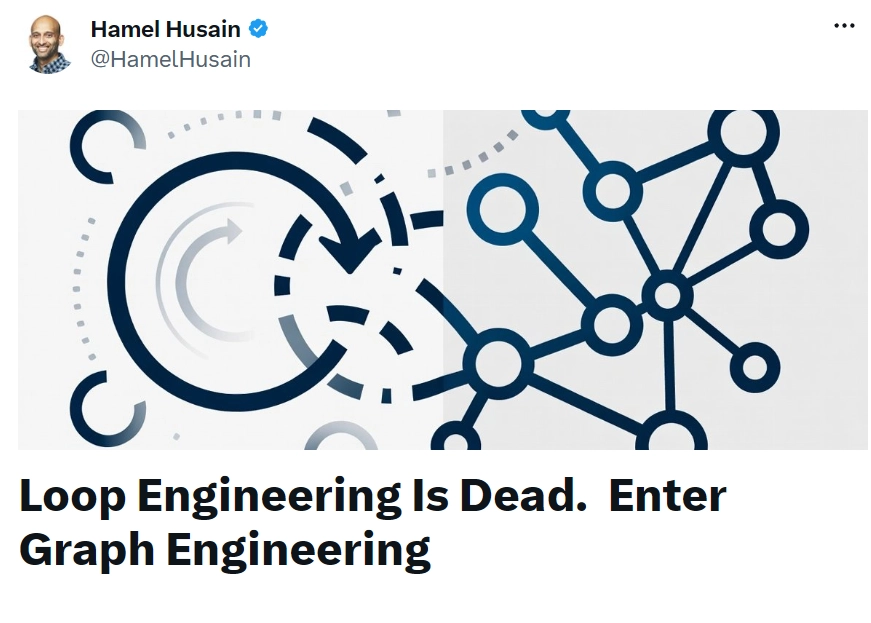
Nghe thì có vẻ giật gân, nhưng anh em khoan hãy đập bỏ code cũ. Thực ra khái niệm Loop Engineering mới nổi được tầm một tháng rưỡi là đã bộc lộ giới hạn.
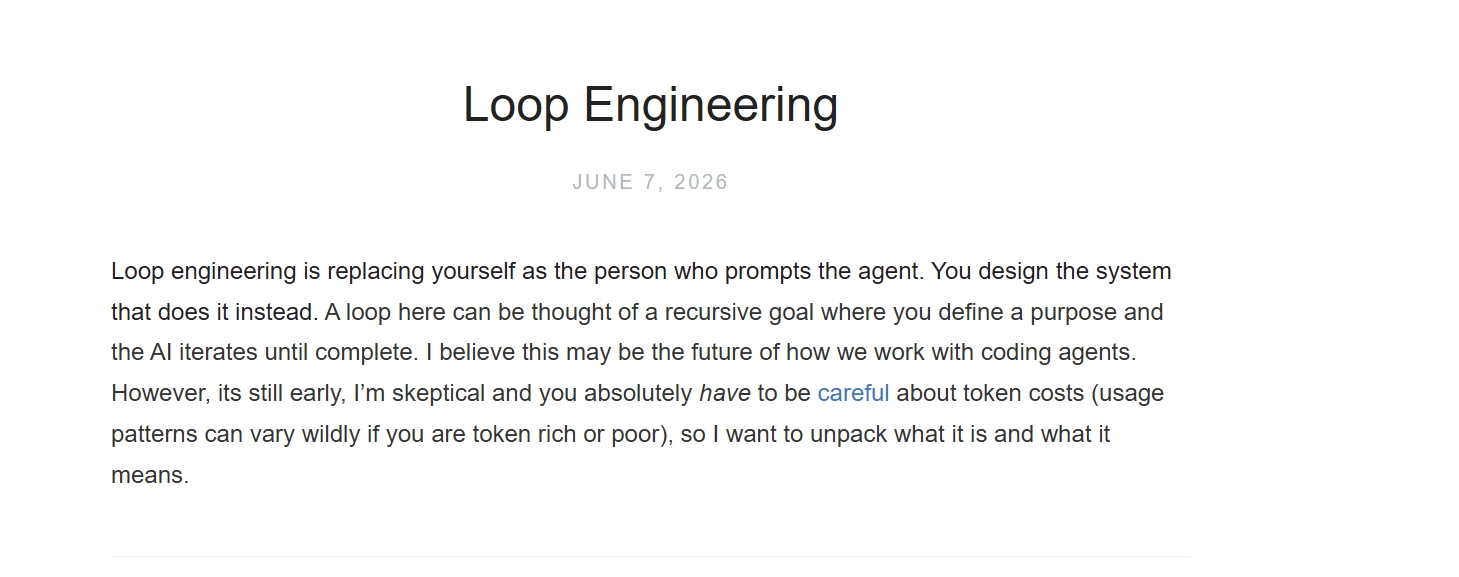
Khi giao cho agent mấy task phức tạp, nó rất dễ bị “ngáo”: kẹt trong những vòng lặp vô tận, tự nhiên bỏ qua các logic nghiệp vụ quan trọng, hoặc cứ gọi tool liên tục đến mức làm tràn luôn cả context window.
Cách diễn giải chính xác và hữu ích nhất không phải là “loop engineering is dead”, mà là: khi một vòng lặp đơn lẻ không còn đủ, thứ chúng ta thu được là một graph — và graph chứa các loop bên trong nó. Graph engineering là cái tên tháng 8/2026 này cho việc thiết kế agent như một hệ thống nhiều-thành-phần có trạng thái (stateful composite workflow): nhiều nhánh song song, bộ kiểm chứng, điểm bàn giao, trạng thái chia sẻ, và điều kiện dừng — thay vì nhồi mọi thứ vào trong một context chat duy nhất.
Tại sao lại cần Graph Engineering?
Trong một hệ thống vòng lặp tác tử đơn lẻ (single-agent loop), mọi quyết định chuyển trạng thái đều bị ẩn bên trong ngữ cảnh của mô hình.
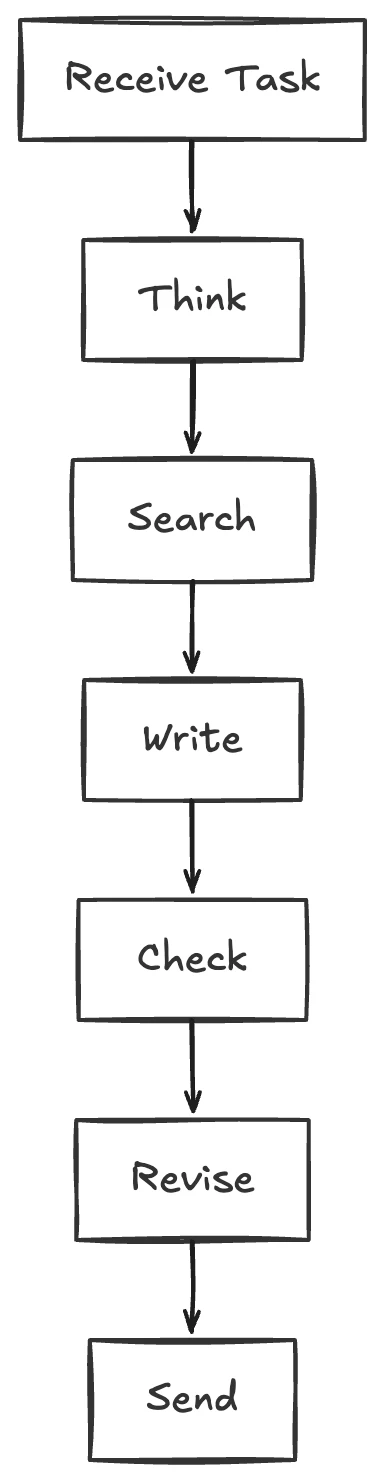 Trong single-agent loop, LLM tự quyết định mọi thứ: khi nào tìm kiếm, khi nào dừng, kết quả đúng hay sai.
Điểm yếu chí mạng của single-agent loop nằm ở việc chúng ta trao cho LLM quá nhiều quyền kiểm soát. Mô hình tự quyết định khi nào cần tìm kiếm, khi nào đã gom đủ dữ liệu, và tự đánh giá xem kết quả đã đạt chuẩn hay chưa. Mô hình này chạy demo thì rất mượt, nhưng đưa lên production lại là một rủi ro quá lớn. LLM rất dễ bị mắc kẹt trong các vòng lặp vô tận, bỏ qua các logic nghiệp vụ cốt lõi, hoặc tự làm tràn context window của chính mình.
Thay vì để AI tự tung tự tác, Graph Engineering vạch ra các ranh giới thực thi rõ ràng. Nguyên tắc ở đây là: quy tắc kinh doanh đã biết thì phải dùng logic lập trình xác định để giải quyết. LLM chỉ được kích hoạt khi hệ thống cần diễn giải ngữ nghĩa, lập kế hoạch hoặc xử lý sự mơ hồ. Các AI Agent vẫn được giữ khả năng suy luận độc lập, nhưng chúng chỉ được phép hoạt động bên trong phạm vi của từng node (sẽ nói ở phần sau). Quyền điều hướng và kiểm soát toàn bộ hệ thống đã được tước bỏ và giao lại cho sơ đồ đồ thị.
Vậy Graph Engineering là gì?
💡 Về bản chất, Graph Engineering là nghệ thuật kiến trúc hóa một hệ thống tác tử, thông qua việc thiết kế tinh vi các điểm nút, hệ thống ranh giới phụ thuộc, cơ chế dịch chuyển trạng thái, các luồng thực thi, chốt kiểm định, lộ trình phục hồi và các ranh giới kiểm soát.
Graph Engineering là nghệ thuật kiến trúc hóa một hệ thống Agent
Các thành phần của Graph Engineering
Một đồ thị điều khiển tác tử tiêu chuẩn bao gồm ba thành phần nguyên tử nền tảng:
1. Node (Nút)
Là một đơn vị thực thi độc lập. Một nút có thể là:
- Một lần gọi LLM
- Một lần con người xác nhận yêu cầu của Agent
- Một phép tính xác định (deterministic computation)
- …
Đáng chú ý, không phải nút nào cũng là AI. Ví dụ, việc tính toán xem một hóa đơn có vượt quá ngưỡng phê duyệt hay không thì không cần dùng đến LLM. Nhưng việc hiểu xem một email có phải là yêu cầu hoàn tiền hay không thì có thể cần dùng đến LLM.
2. Edges (Cạnh)
Nếu các node đóng vai trò là những đơn vị xử lý chuyên biệt, thì các cạnh (edges) chính là hệ thống điều phối cốt lõi. Chúng đảm nhận nhiệm vụ xác định chính xác luồng thực thi tiếp theo, đại diện cho các quy tắc điều hướng nghiệp vụ của toàn bộ hệ thống.
- Direct edges — kết nối trực tiếp, không điều kiện, đầu ra của tác vụ trước lập tức trở thành đầu vào cho tác vụ sau mà không cần logic rẽ nhánh
- Conditional edges — rẽ nhánh dựa trên điều kiện, đầu ra của tác vụ trước sẽ được đưa vào các node nhánh khác nhau dựa trên các điều kiện logic được định nghĩa trước
- Parallel edges — rẽ nhánh song song, cho phép một tác vụ được gửi đến nhiều tác vụ con cùng lúc, giúp giảm latency và tổng hợp đa góc nhìn.
- Looping edges — Khi kết quả từ một node không đạt chuẩn (thông qua bộ kiểm định), cạnh này chuyển hướng luồng công việc quay ngược lại nút trước đó kèm theo ngữ cảnh lỗi, bắt buộc Agent phải tự sửa sai và tối ưu hóa trước khi được phép đi tiếp.
- Error edges — Xử lý lỗi, khi có lỗi xảy ra ở một node (ví dụ như model bị hallucination), edge này sẽ kích hoạt một nút xử lý lỗi chuyên dụng, giúp hệ thống có khả năng tự phục hồi.
- Human-controlled edges — chờ con người phê duyệt, edge này sẽ tạm dừng luồng công việc và chờ con người can thiệp hoặc phê duyệt khi thực thi các task có rủi ro.
- Event-triggered edges — kích hoạt bởi sự kiện bên ngoài, edge này sẽ kích hoạt luồng công việc dựa trên các sự kiện bên ngoài.
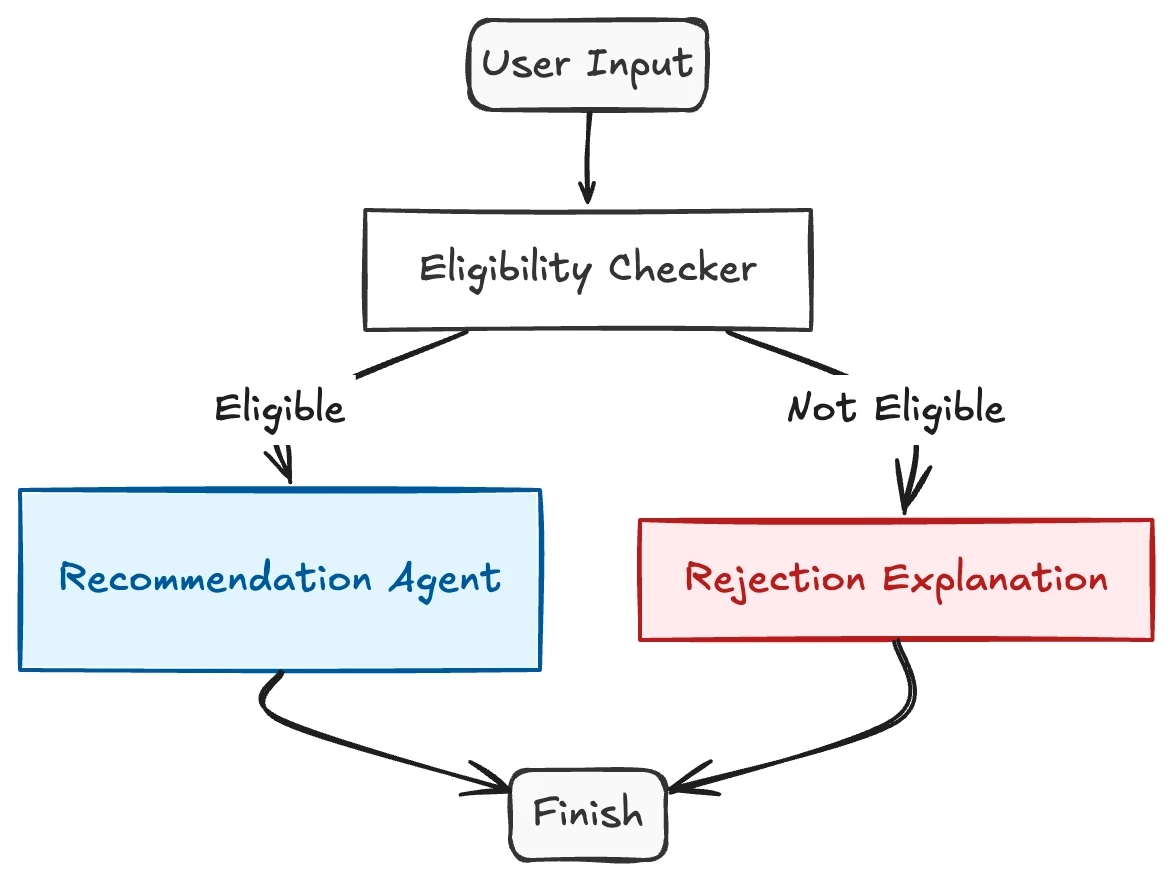 Bảy loại cạnh cơ bản trong một đồ thị điều khiển tác tử.
3. State (Trạng thái)
Nếu các Nút (Nodes) là những nhân viên chuyên trách, các Cạnh (Edges) là luồng luân chuyển, thì State chính là “cuốn hồ sơ dự án” được truyền tay giữa họ. Nó lưu chuyển dọc theo các cạnh, giúp hệ thống đa tác tử không bị “mất trí nhớ” hay đứt đoạn ngữ cảnh khi giao việc từ bước này sang bước khác. Về mặt dữ liệu, thay vì nhồi nhét mọi thứ vào một khung chat duy nhất, State gom gói toàn bộ bối cảnh phiên chạy một cách có cấu trúc:
- Nhiệm vụ gốc (Task): Yêu cầu đầu vào ban đầu.
- Tạo tác trung gian (Artifacts/Drafts): Các bản nháp, đoạn code, hoặc sản phẩm đang làm dở.
- Ghi chú nghiên cứu (Notes): Dữ liệu thô, kết quả tìm kiếm mà tác tử gom nhặt dọc đường.
- Chốt kiểm định (Verdicts/Checks): Trạng thái pass/fail, điểm số đánh giá từ các nút kiểm duyệt trước đó.
4. State Reducers (Cơ chế tổng hợp trạng thái)
Trong các kiến trúc rẽ nhánh song song (fan-out), khi nhiều tác tử (ví dụ: ba tác tử nghiên cứu độc lập) cùng lúc trả về kết quả và cập nhật chung vào một trường dữ liệu, nguy cơ ghi đè (overwrite) hoặc thất thoát dữ liệu là cực kỳ lớn. Đây là lúc hệ thống cần đến Reducer (Bộ tổng hợp/giảm). Reducer đóng vai trò như một “trọng tài” tại điểm hội tụ (fan-in), tự động áp dụng các quy tắc hợp nhất dữ liệu — như nối danh sách, gộp từ điển, hoặc giải quyết xung đột — để đảm bảo trạng thái hệ thống được cập nhật an toàn và toàn vẹn.
5. Checkpoints (Điểm lưu trạng thái)
Checkpoint là cơ chế snapshot của toàn bộ đồ thị tại một thời điểm thực thi cụ thể. Trong production, Checkpoint không chỉ để chống mất mát dữ liệu mà còn là nền tảng cốt lõi để workflow có thể:
- Phục hồi sau lỗi: Khôi phục tức thì sau các sự cố crash, lỗi mạng, hoặc bảo vệ thành quả của các tác vụ chạy nền dài hạn khỏi nguy cơ bị timeout.
- Gỡ lỗi & Kiểm toán: Cho phép kỹ sư truy xuất ngược về các trạng thái trong quá khứ để theo dõi chính xác từng quyết định của AI.
- Phát lại: Tua lại và chạy tiếp quy trình từ đúng một điểm bị lỗi thay vì phải gọi lại (tốn tiền token) từ đầu.
6. Interrupts (Ngắt)
Nếu Checkpoint là cơ chế lưu trữ, thì Interrupt là “phanh khẩn cấp” của hệ thống. Nó tạm đóng băng luồng thực thi để nhường quyền kiểm soát cho các yếu tố bên ngoài (human-in-the-loop). Kỹ thuật này bắt buộc phải có khi: Chờ phê duyệt (Approval): Trước khi AI thực hiện các hành động có rủi ro cao (gửi email cho tệp khách hàng lớn, thực thi lệnh xóa database, v.v.). Xử lý sự mơ hồ: Yêu cầu con người cung cấp thêm dữ liệu đầu vào khi tác tử không thể (hoặc không được phép) tự suy luận tiếp.
Cách hoạt động trong LangGraph: Khi một interrupt xảy ra, LangGraph sẽ tự động lưu checkpoint của đồ thị. Sau đó, nó cho phép quy trình thực thi được tiếp tục (resume) vào một thời điểm sau đó bằng cách sử dụng cùng một định danh luồng (thread identifier).
💡 Mẹo kỹ thuật: Tài liệu chính thức khuyến nghị rằng bạn nên đảm bảo các tác dụng phụ (side effects) xảy ra trước điểm ngắt phải có tính lũy đẳng (idempotent).
Giải thích nhanh: “Lũy đẳng” nghĩa là dù thao tác đó có bị thực thi lại nhiều lần do cơ chế retry hoặc resume, nó cũng chỉ tạo ra cùng một kết quả cuối cùng, không gây ra lỗi trùng lặp dữ liệu hay hành động thừa — ví dụ: không gửi 2 email giống hệt nhau cho cùng một người.
Graph Patterns
Pattern 1: Prompt Chaining
Prompt Chaining đóng vai trò là một khối xây dựng cơ bản (building block) cho các đồ thị tác tử, đặc biệt khi hệ thống được mở rộng thành các luồng công việc phi tuyến tính hoặc có tính chu kỳ. Về mặt cơ chế, đầu ra của nút này sẽ trở thành đầu vào cho nút tiếp theo.
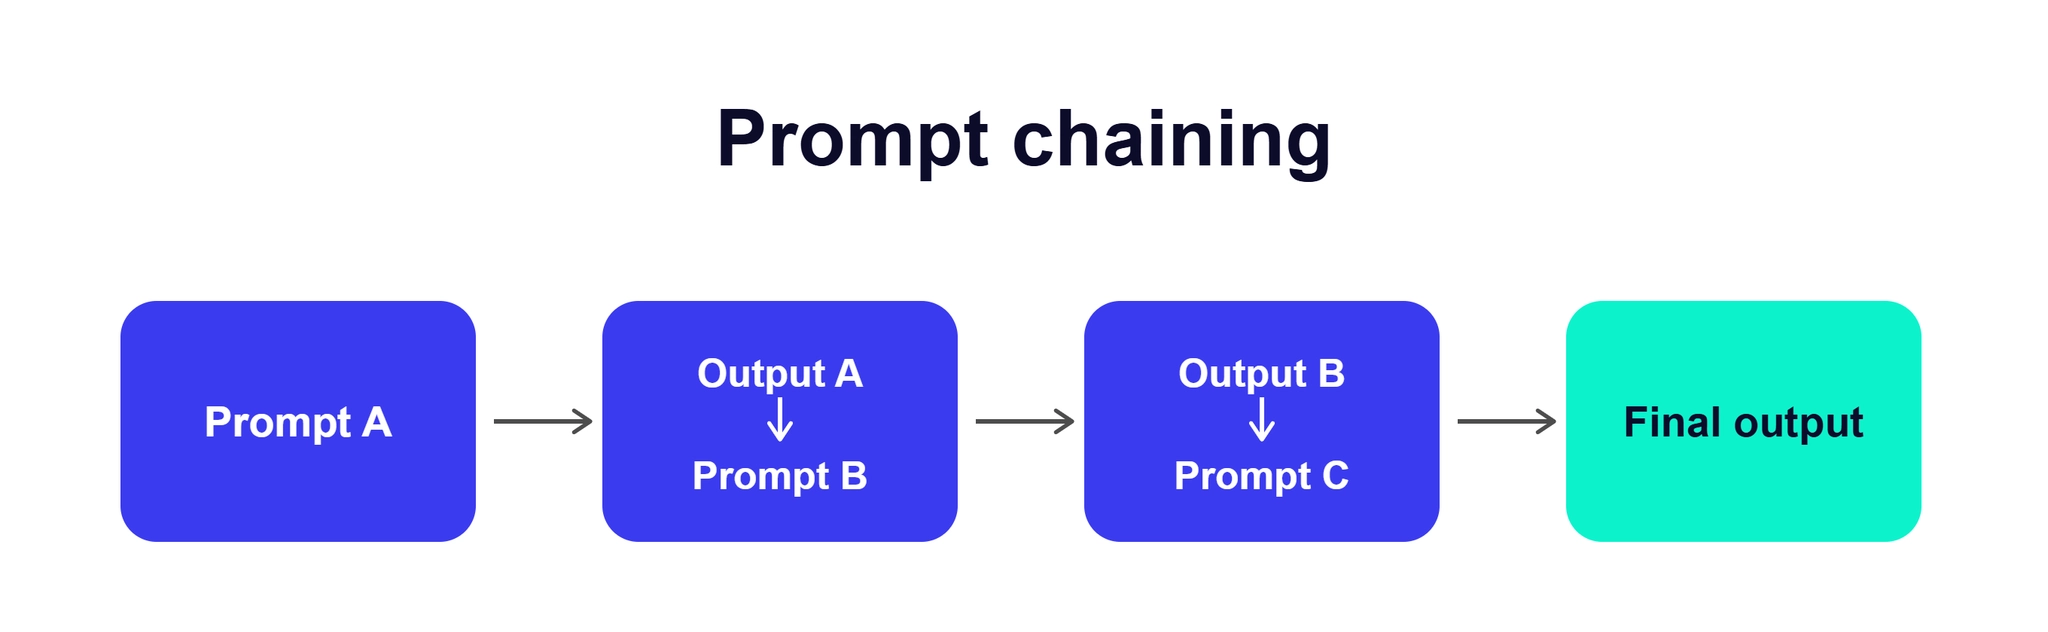 Prompt Chaining với context isolation: mỗi nút bắt đầu với “cửa sổ ngữ cảnh sạch”, chỉ chứa dữ liệu cần thiết.
Nhiều tài liệu thường giải thích pattern này theo hướng chuyên môn hóa vai trò (ví dụ: tác tử nghiên cứu → tác tử viết bài → biên tập viên). Tuy nhiên, cách giải thích đó đã bỏ qua một lợi ích mang tính kiến trúc cốt lõi nhất của việc chia chuỗi: Cô lập ngữ cảnh (Context Isolation).
Tại sao cần cô lập ngữ cảnh?
Trong bước đầu tiên của luồng công việc, tác tử thường tích lũy một lượng lớn token chứa các dữ liệu thô, kết quả tìm kiếm, tool output, hoặc cả những suy luận sai lầm. Bước thứ hai thường không cần đến đống dữ liệu hỗn độn này, và việc nhồi nhét chúng vào sẽ làm suy giảm chất lượng kết quả một cách rõ rệt. Việc thiết lập ranh giới (node boundary) trong đồ thị giúp tác tử ở bước hai bắt đầu với một “cửa sổ ngữ cảnh sạch”, chỉ chứa đúng những thông tin mà nó cần.
Pattern này hoạt động tốt nhất khi một tác vụ có thể được phân rã rõ ràng thành các bài toán nhỏ (subtasks), trong đó mỗi bước có yêu cầu về ngữ cảnh hoàn toàn khác biệt. Ví dụ: Nút trích xuất tạo ra dữ liệu có cấu trúc; Nút định dạng chỉ cần dữ liệu đó chứ không cần toàn bộ văn bản thô ban đầu.
Dấu hiệu nên bỏ qua (Skip when): Khi các bước quá gắn kết với nhau khiến bạn đằng nào cũng phải chuyển tiếp toàn bộ trạng thái (state) đi tiếp. Dấu hiệu nhận biết rõ nhất là khi đối tượng trạng thái của hệ thống chỉ liên tục “phình to” qua mỗi bước, và mọi nút đều phải đọc toàn bộ kết quả của nút trước đó. Lúc này, bạn chỉ đang có “một nút với 3 prompt khác nhau”, và việc thêm các bước chuyển nút (hops) chỉ làm tăng độ trễ (latency) một cách vô ích.
3 nguyên tắc triển khai an toàn
Để triển khai Prompt Chaining an toàn và hiệu quả, các kỹ sư cần lưu ý 3 nguyên tắc sau tại ranh giới giữa các nút:
- Thiết lập danh sách trắng (Whitelist): Lựa chọn và chỉ định rõ ràng những dữ liệu nào mỗi nút được phép nhận, thay vì truyền toàn bộ trạng thái chia sẻ (shared state) một cách bừa bãi.
- Định nghĩa kiểu dữ liệu bàn giao (Type the handoff): Giao tiếp giữa các nút cần có lược đồ dữ liệu (schema) cụ thể. Nếu có sự thay đổi về cấu trúc, hệ thống sẽ vỡ (break) ngay tại ranh giới đó để dễ gỡ lỗi, thay vì lan truyền lỗi xuống tận 3 nút hạ nguồn.
- Tóm tắt tại biên (Summarize at the edge): Nếu đầu ra của nút thượng nguồn (upstream) quá lớn, hãy tóm tắt nó. Bản tóm tắt thường cung cấp chính xác những gì nút tiếp theo cần và có chi phí prompt rẻ hơn hẳn một bậc.
Pattern 2: Routing
Trong Kỹ thuật Đồ thị, định tuyến (routing) là một mẫu thiết kế quen thuộc nhưng lại được xem là “bước tối ưu cấu trúc mang lại hiệu quả cao nhất với chi phí thấp nhất” (the cheapest structural win). Ở pattern này, một nút làm nhiệm vụ phân loại dữ liệu đầu vào, sau đó một “cạnh có điều kiện” (conditional edge) sẽ điều hướng luồng công việc xuống một trong nhiều nhánh xử lý chuyên biệt.
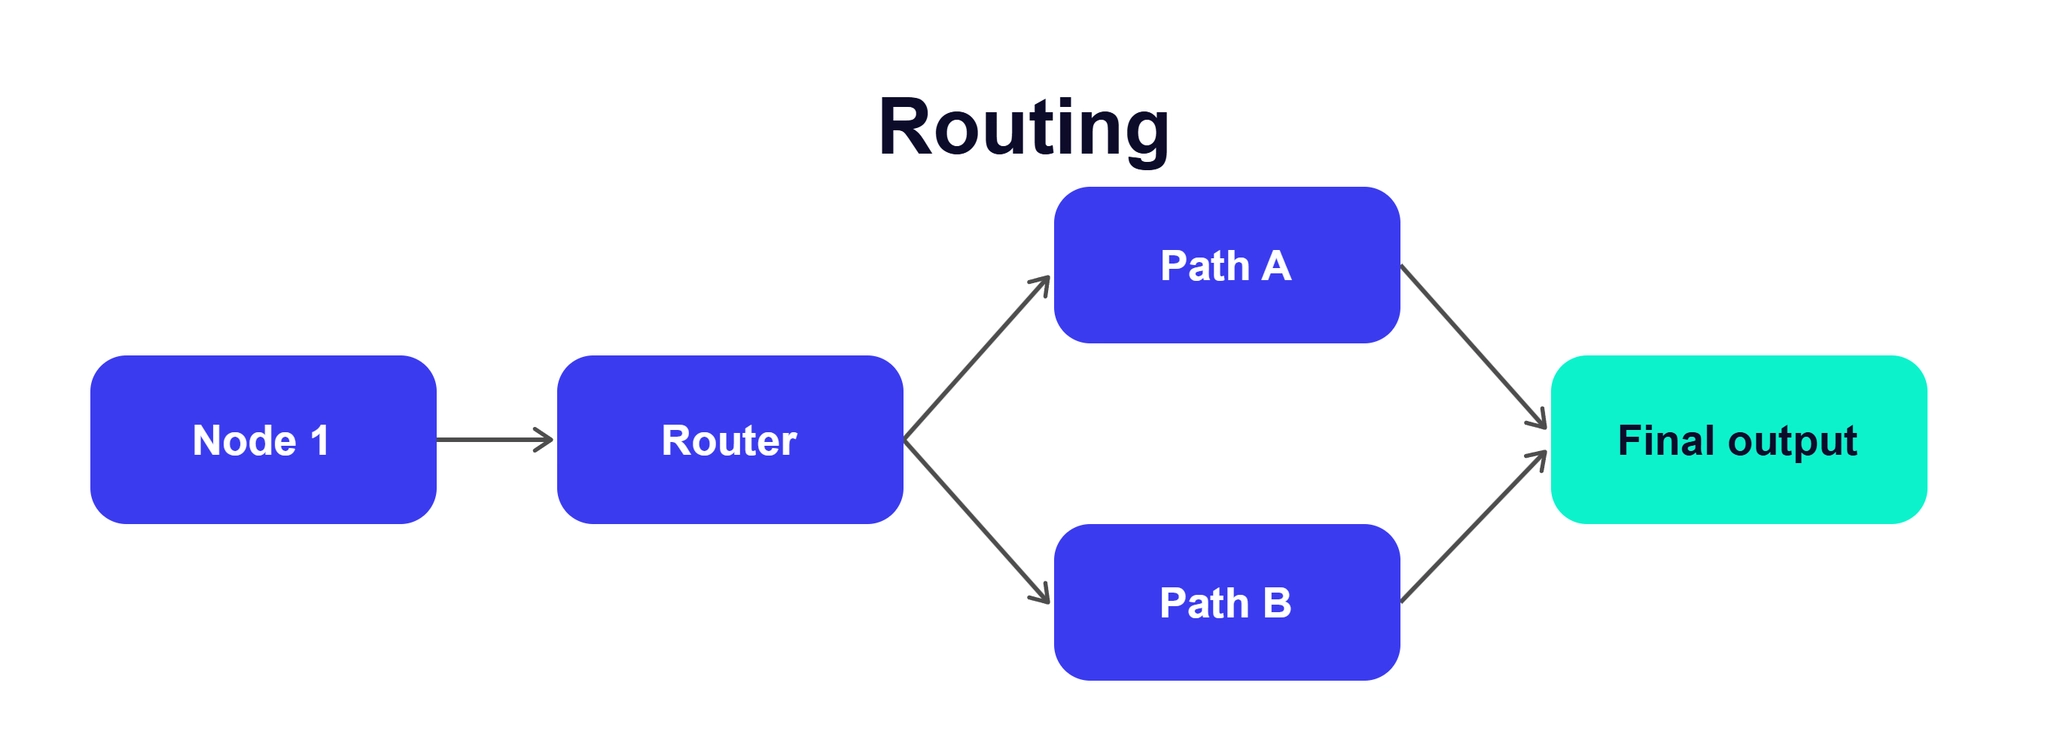 Routing pattern: khớp chi phí với độ khó — tác vụ đơn giản đi nhánh rẻ, tác vụ phức tạp đi nhánh đắt.
Trong thực tế, bạn có thể thiết kế hai loại bộ định tuyến:
- Định tuyến xác định (Deterministic routing): Sử dụng các quy tắc lập trình (code if/else) nếu các tiêu chí phân loại đã rõ ràng và chính xác.
- Định tuyến dựa trên mô hình (Model-based routing): Gọi một LLM để phân loại khi đầu vào mang tính mơ hồ và cần diễn giải ngữ nghĩa. Đáng chú ý, nút định tuyến không trực tiếp điều khiển đồ thị; nó chỉ cập nhật hoặc đọc trạng thái (state) để quyết định cạnh nào được phép kích hoạt.
Tại sao Routing lại quan trọng?
Lợi ích cốt lõi của pattern này là cho phép bạn khớp chi phí với độ khó của bài toán (match cost to difficulty).
Ví dụ thực tế:
- Xử lý Ticket Hỗ trợ (Support Graph): Một đồ thị phân loại ticket có thể gửi các yêu cầu đơn giản (đổi mật khẩu, hỏi giờ làm việc) đến một mô hình nhỏ để tiết kiệm token và tăng tốc độ phản hồi. Ngược lại, các vấn đề mơ hồ và phức tạp sẽ được định tuyến tới mô hình lớn (như GPT-5 hay Claude Sonnet 5) với khả năng suy luận mạnh mẽ hơn.
- Đánh giá Mã nguồn (Code Review): Khi đánh giá một Pull Request (PR), hệ thống có thể định tuyến dựa trên “bán kính ảnh hưởng” (blast radius). Các lỗi typo hoặc cập nhật document đi vào nhánh giá rẻ; các thay đổi liên quan đến module xác thực (auth), thanh toán (payments) hay di chuyển dữ liệu (migrations) sẽ đi vào nhánh đắt tiền hơn — sử dụng nhiều công cụ kiểm chứng hơn và bắt buộc có cổng chờ con người phê duyệt (human approval) trước khi merge.
Tiêu chí áp dụng
- Điểm lý tưởng (Best used): Routing phát huy tối đa sức mạnh khi các nhánh thực thi có sự khác biệt rõ rệt về mặt bản chất: sử dụng các mô hình khác nhau, bộ công cụ khác nhau, ngân sách khác nhau hoặc yêu cầu phê duyệt khác nhau.
- Dấu hiệu nên bỏ qua (Skip when): Nếu hai nhánh của bạn thực chất chỉ chạy cùng một nút duy nhất với một câu lệnh (prompt) được tinh chỉnh hơi khác một chút, thì đó là một “tham số” (parameter), không phải là một “nhánh đồ thị” (path). Đừng vẽ thêm nhánh nếu không có sự khác biệt về luồng công việc.
Cạm bẫy “Cái chết âm thầm” (Silent Failure)
Điểm yếu chí mạng của pattern này là khi bộ định tuyến trở thành mắt xích yếu nhất trong hệ thống.
Nếu mọi bước xử lý ở hạ nguồn (downstream) đều hoàn toàn phụ thuộc vào kết quả phân loại của bộ định tuyến, và bộ định tuyến lại dự đoán sai, hệ thống sẽ không báo lỗi (doesn’t fail loudly). Thay vào đó, tác vụ bị định tuyến sai vẫn sẽ hoàn thành một cách trơn tru, nhưng đi nhầm đường và tạo ra một kết quả hoàn toàn vô nghĩa.
Best Practices để xây dựng Router
- Đo lường bằng dữ liệu thực: Hãy kiểm định và đánh giá (validate) bộ định tuyến bằng các tập dữ liệu mẫu đã gán nhãn trước khi đưa lên production, và liên tục giám sát độ chính xác của nó. Phần lớn sự cố của mô hình định tuyến đến từ việc chúng phân loại sai.
- Thiết lập đường lùi “Bảo thủ” (Conservative Fallback): Đối với các đầu vào mà hệ thống không nhận diện được hoặc có độ tự tin thấp, hãy thiết lập cho chúng cùng một đích đến: Nhánh bảo thủ nhất. Thông thường, đây là nhánh đắt tiền nhất hoặc nhánh yêu cầu con người can thiệp. Việc đẩy một công việc bị định tuyến sai hoặc không rõ ràng vào một “nhánh giá rẻ mặc định” chính là công thức hoàn hảo để tạo ra rác.
Pattern 3: Parallelization
Trong kiến trúc đồ thị, xử lý song song (parallelization) là cơ chế rẽ nhánh đồng thời (fan-out) luồng công việc tới nhiều nút xử lý cùng lúc và sau đó hội tụ lại tại một điểm nối (fan-in). Việc thực thi đồng thời các luồng công việc độc lập chính là một trong những lợi ích cốt lõi nhất của hệ thống đồ thị, điều mà cấu trúc vòng lặp đơn lẻ (single loop) về mặt cấu trúc không thể thực hiện được.
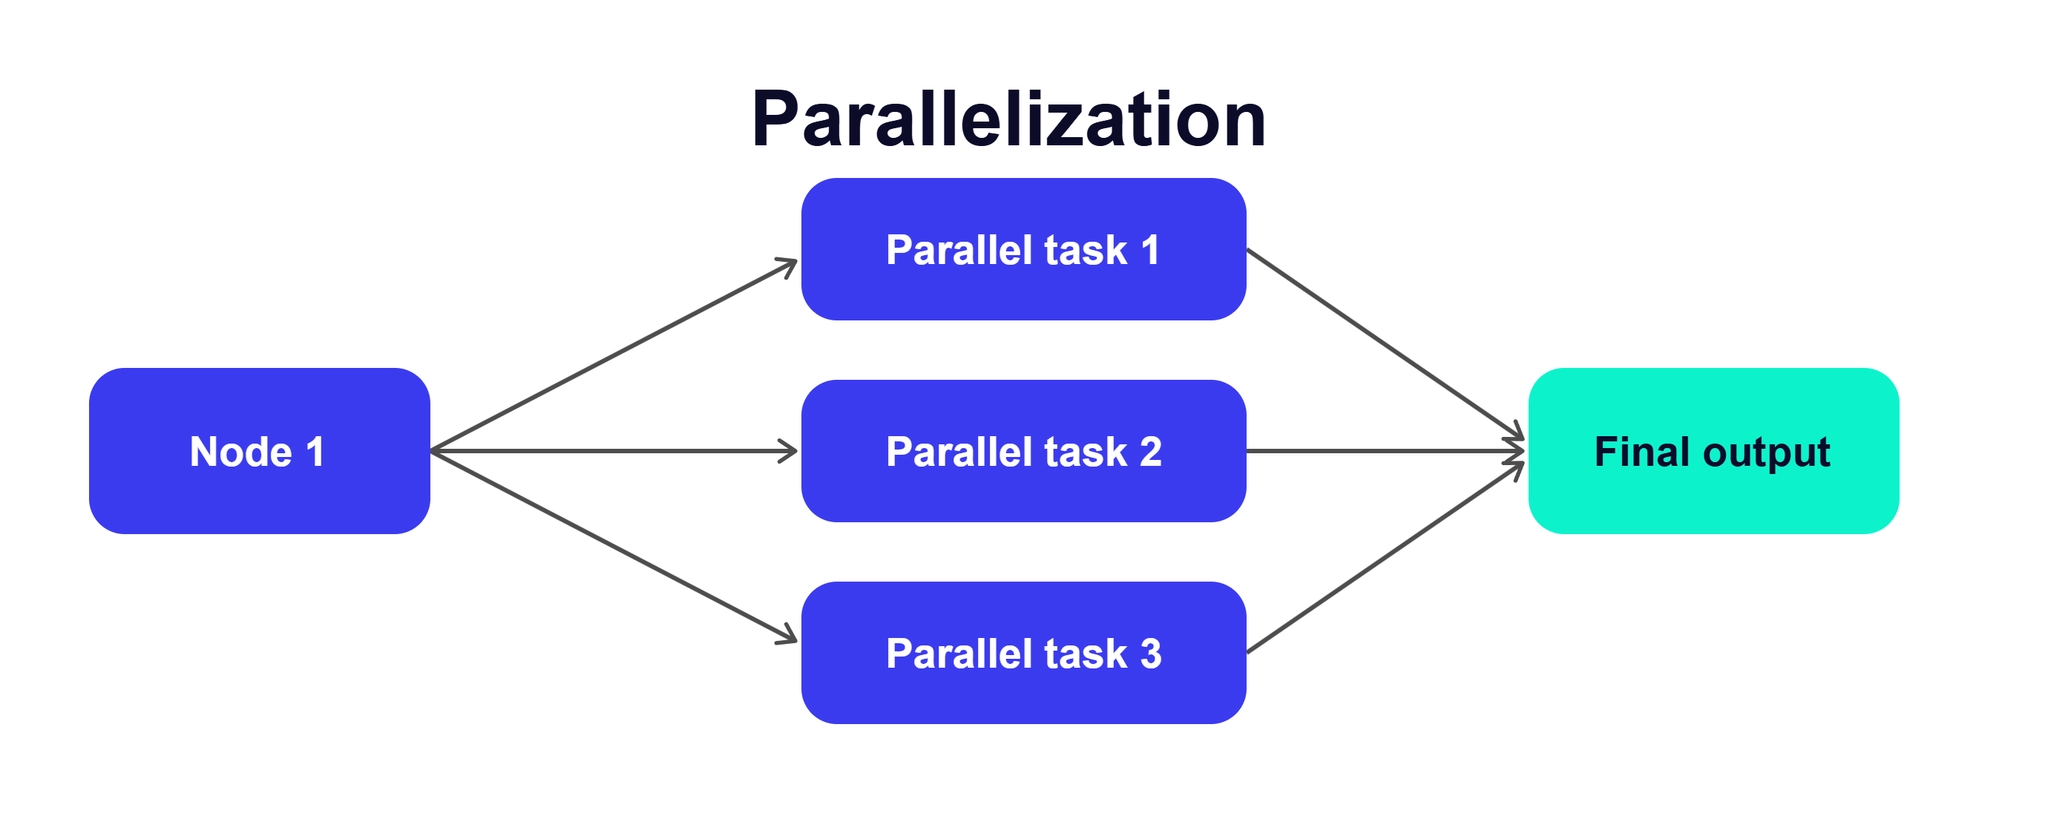 Fan-out/Fan-in: nhiều worker chạy đồng thời, kết quả hội tụ tại nút join thông qua state reducer.
Lợi ích chiến lược: Giảm độ trễ và Kiểm chứng đa chiều
Mẫu thiết kế này đặc biệt tỏa sáng trong các trường hợp yêu cầu độ trễ thấp hoặc đòi hỏi sự tổng hợp từ nhiều góc nhìn khác nhau:
- Tối ưu hóa độ trễ cho ứng dụng thời gian thực: Chẳng hạn, một tổng đài viên AI (AI phone agent) hoạt động trên các cuộc gọi thoại có ngân sách độ trễ chỉ tính bằng mili-giây. Hệ thống phải xử lý giọng nói đầu vào, gửi đến một tác tử nhận diện ý định, sau đó rẽ nhánh song song tới các tác tử khác để tra cứu tài khoản, kiểm tra chính sách và chi tiết hợp đồng cùng lúc. Cuối cùng, ngữ cảnh sẽ hội tụ lại tại một nút soạn thảo câu trả lời và đi qua cổng kiểm duyệt trước khi phản hồi.
- Đa góc nhìn và đánh giá chéo: Khi cần các kết quả có độ tin cậy cao, việc triển khai nhiều tác tử hoạt động song song là vô cùng hữu ích. Chẳng hạn, trong một sản phẩm bảo mật, bạn có thể triển khai hai hay nhiều tác tử độc lập cùng đồng thời rà soát một đoạn mã nguồn để tìm kiếm lỗ hổng bảo mật.
Những cạm bẫy kiến trúc cần lưu ý
Việc lạm dụng xử lý song song có thể dẫn đến những hệ quả tiêu cực về cả chi phí lẫn hiệu năng:
- Đánh đổi tài chính lấy độ trễ (Buying latency with money): Nếu các luồng công nhân (workers) chạy song song yêu cầu đọc cùng một ngữ cảnh đầu vào, bạn đang phải trả chi phí xử lý token gấp nhiều lần cho cùng một lượng ngữ cảnh đó. Đây là sự đánh đổi xứng đáng cho user-facing tasks, nhưng lại lãng phí cho batch jobs.
- Nút thắt cổ chai tại nhánh chậm nhất: Tốc độ cải thiện của toàn bộ hệ thống bị giới hạn bởi độ trễ của nhánh thực thi chậm nhất. Nếu bạn có bốn nút hoàn thành trong 10 giây nhưng một nút mất tới 90 giây, thời gian chờ tại điểm hội tụ (join) vẫn sẽ là hơn 90 giây.
- Thảm họa tranh chấp dữ liệu (Race Conditions): Khi rẽ nhánh song song, việc hai hay nhiều nút cùng thực hiện thay đổi trên một trường dữ liệu của trạng thái chia sẻ (shared state) sẽ dẫn đến tình trạng tranh chấp không xác định.
Best Practices cho môi trường sản xuất
- Dữ liệu bất biến tại các nhánh (Immutable Branching): Tuyệt đối không cho phép các nhánh song song trực tiếp thay đổi (mutate) trạng thái chung. Các nhánh chỉ nên trả về kết quả độc lập dưới dạng dữ liệu bất biến. Việc gộp dữ liệu phải được thực hiện một cách tường minh tại nút hội tụ (join node) thông qua các bộ giảm trạng thái (state reducers), với quy tắc thiết kế chuẩn mực là mỗi trường dữ liệu chỉ được phép có duy nhất một nút có quyền ghi.
- Thiết lập chính sách chịu lỗi một phần (Partial Results & Timeouts): Hệ thống không thể phó mặc dòng thực thi khi một nhánh gặp sự cố. Bạn cần thiết lập giới hạn thời gian (timeouts) riêng cho từng nhánh và quyết định rõ ràng chính sách tại nút hội tụ. Ví dụ: nếu chỉ có ba trên năm nguồn dữ liệu trả về kết quả, hệ thống sẽ tiếp tục thực thi với kết quả một phần, tiến hành thử lại (retry), hay lập tức đánh rớt toàn bộ phiên chạy?
Pattern 4: Orchestrator-Workers
Trong Kỹ thuật Đồ thị, mô hình Điều phối viên - Công nhân (Orchestrator-Workers) là một bước tiến xa hơn so với xử lý song song thông thường. Ở pattern này, một nút đóng vai trò là “người điều phối” sẽ tự động phân rã một nhiệm vụ tổng thể, quyết định ngay tại thời gian chạy (runtime) xem cần sinh ra (spawn) bao nhiêu tác tử công nhân, mỗi công nhân sẽ làm gì, và cuối cùng tổng hợp kết quả của chúng.
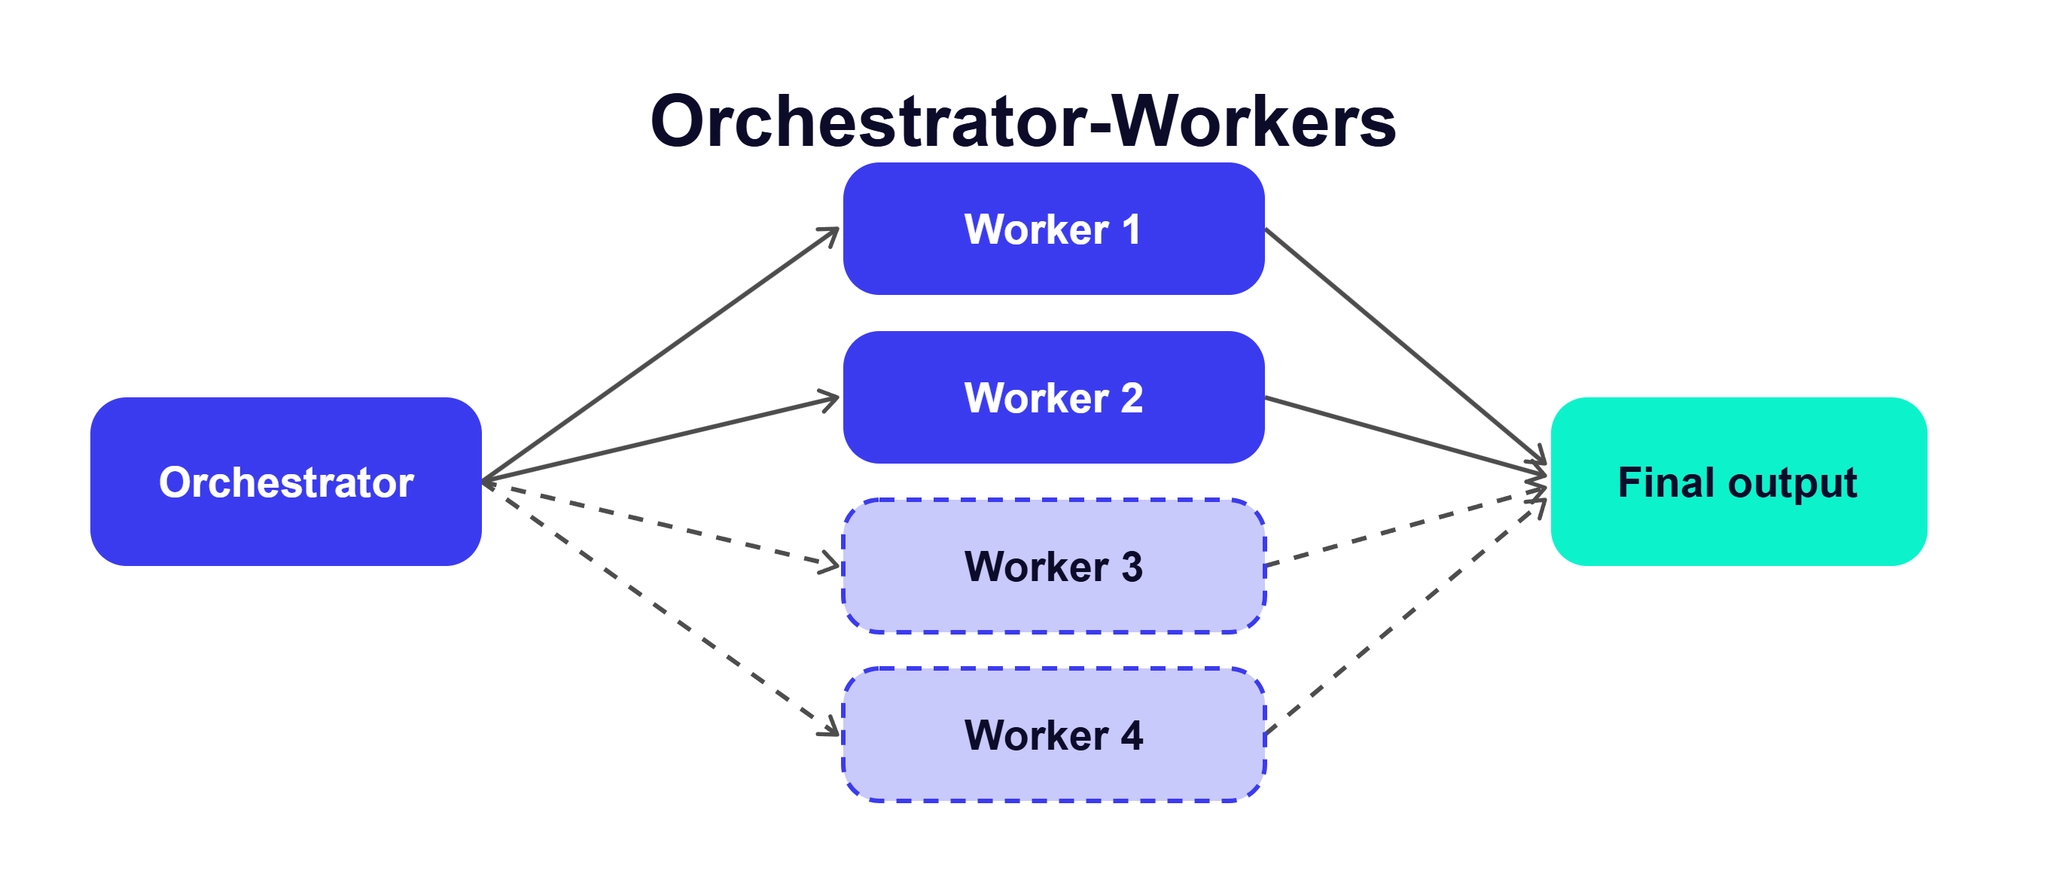 Orchestrator-Workers: hình thù đồ thị chỉ được xác định tại thời gian chạy.
Điểm đặc biệt nhất của pattern này là bạn hoàn toàn không biết trước độ rộng rẽ nhánh (fan-out width), danh tính của các công nhân hay hình thù của đồ thị cho đến khi nó thực sự chạy.
Tại sao và khi nào nên sử dụng?
- Điểm lý tưởng (Best used): Mẫu kiến trúc này tỏa sáng khi danh sách các công việc con không thể được liệt kê trước khi bắt đầu do phạm vi nhiệm vụ quá rộng.
- Ví dụ: Cấu trúc lại một API cũ trên một kho mã nguồn lớn. Bạn sẽ không thể định nghĩa một đồ thị tĩnh vì bạn chưa biết API đó được dùng ở những tệp nào. Thay vào đó, tác tử điều phối sẽ quét kho mã nguồn để khám phá danh sách công việc, sau đó tự động rẽ nhánh tạo ra một tác tử công nhân cho mỗi tệp hoặc mỗi module bị ảnh hưởng.
- Dấu hiệu nên bỏ qua (Skip when): Nếu bạn có thể tự viết ra danh sách tác vụ hoặc trích xuất nó bằng một câu truy vấn (query) đơn giản, hãy quay về sử dụng Pattern 3 (Parallelization) để giữ cho cấu trúc đồ thị là tĩnh và dễ kiểm soát.
Những “bất ngờ” trên môi trường sản xuất
- Sự bùng nổ rẽ nhánh (Unbounded fan-out): Mặc định, độ rộng rẽ nhánh của điều phối viên là không có giới hạn. Nếu nó quyết định sinh ra 40 công nhân và cả 40 cùng gọi đến một API bị giới hạn băng thông, hệ thống sẽ gặp lỗi quá tải (429 Too Many Requests) và sụp đổ.
- Cấu trúc Topo không xác định (Non-deterministic topology): Hai lần chạy trên cùng một đầu vào có thể tạo ra hai hình thù đồ thị khác nhau, phá vỡ phương pháp gỡ lỗi truyền thống.
- Thảm họa tổng hợp dữ liệu (Aggregation complexity): Các kết quả có thể trả về không theo thứ tự, một số công nhân có thể gặp lỗi giữa chừng, hoặc công nhân trả lời một vấn đề hơi chệch hướng so với kế hoạch ban đầu. Một nút tổng hợp không có cơ chế đối chiếu kết quả với kế hoạch gốc sẽ tạo ra một bản báo cáo đầy tự tin nhưng lại thiếu mất 20% lượng công việc.
Best Practices
- Thiết lập trần giới hạn (Explicit Ceilings): Phải đặt ra các giới hạn nghiêm ngặt về độ rộng rẽ nhánh, độ sâu đệ quy, và chi phí tài chính (spend ceilings).
- Quản lý ngân sách theo nhánh (Subtree Token Budget): Hãy thiết lập ngân sách token cho toàn bộ một nhánh phân cấp (subtree) thay vì cấp ngân sách cho từng công nhân lẻ tẻ.
- Lưu trữ bản kế hoạch như một tạo tác bất biến (Durable Artifact): Hãy luôn lưu lại bản kế hoạch phân công ban đầu. Khi một phiên chạy bị lỗi, câu hỏi thường trực luôn là “Kế hoạch phân rã bị sai, hay quá trình thực thi của công nhân bị hỏng?”. Bạn sẽ không thể trả lời câu hỏi này nếu không có bản kế hoạch gốc để đối chiếu.
Pattern 5: Evaluator-Optimizer
Về bản chất, mẫu “Người đánh giá - Người tối ưu hóa” chính là một vòng lặp (loop) được đặt bên trong một đồ thị. Trong pattern này, quy trình hoạt động theo một chu trình khép kín: một thành phần tạo ra kết quả (generate), một thành phần khác đánh giá (evaluate), vòng lặp sẽ quay lại nếu thất bại và thoát ra khi thành công hoặc khi chạm một ngưỡng giới hạn đã thiết lập.
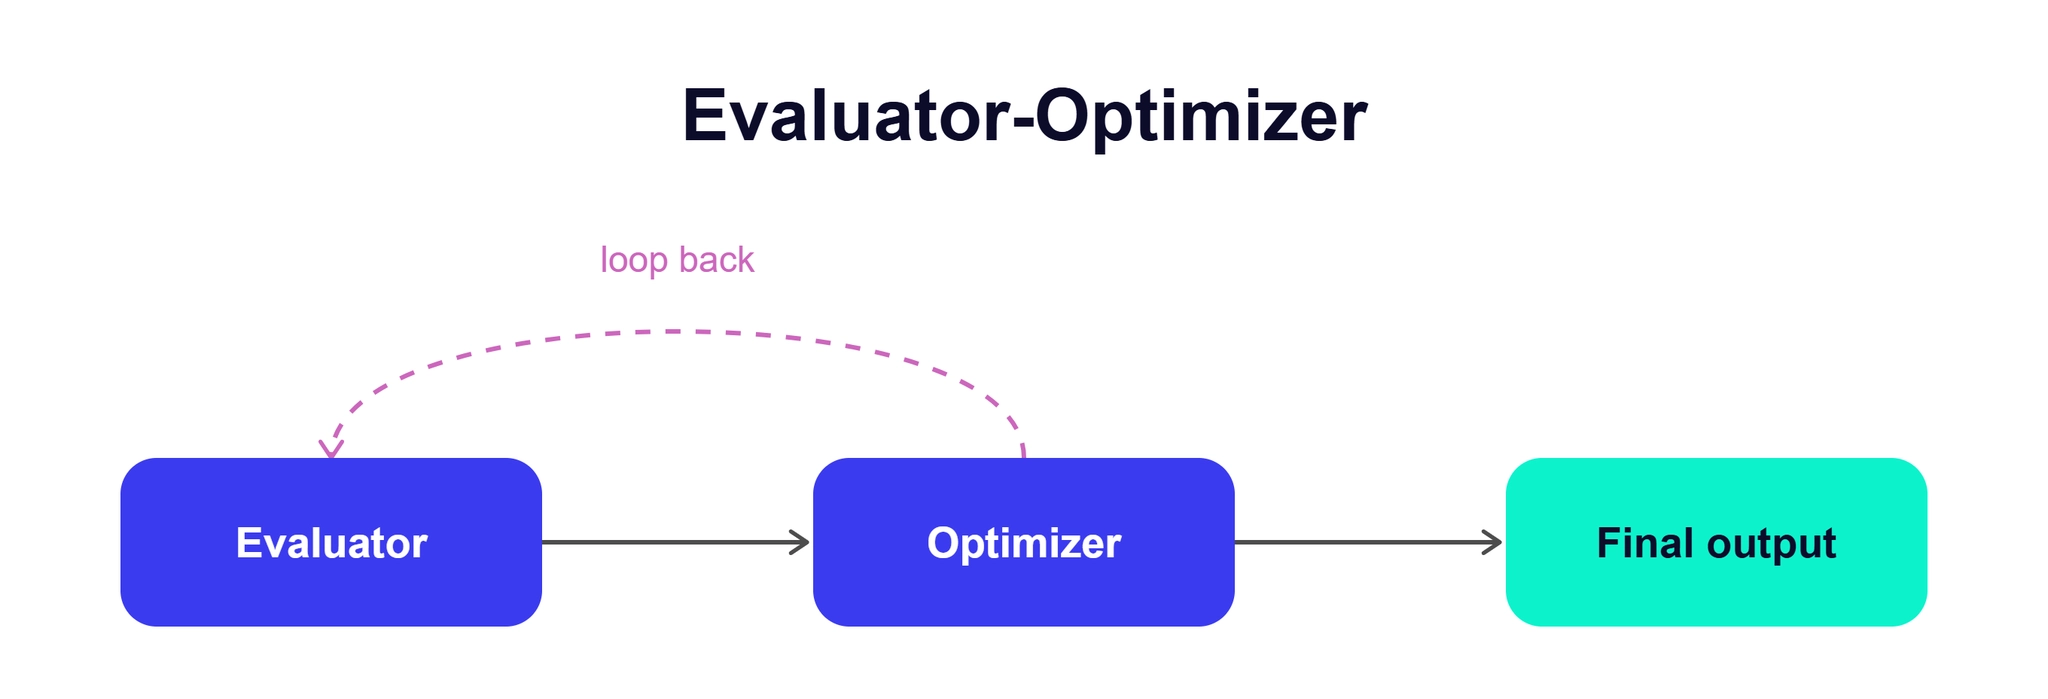 Evaluator-Optimizer: vòng lặp có kiểm soát — generate, evaluate, lặp lại cho đến khi đạt hoặc hết quota.
Tại sao và khi nào nên sử dụng?
Mô hình này hoạt động hiệu quả nhất khi các tiêu chí đánh giá được xác định rõ ràng và mỗi lần sửa đổi đều mang lại sự cải thiện có thể đo lường được.
Điểm lý tưởng (Best used): Khi bạn có thể định nghĩa điều kiện thành công (pass condition) ngay từ trước khi chạy và có thể kiểm tra nó một cách tự động. Ví dụ: Một đồ thị có nhiệm vụ tối ưu hóa một truy vấn cơ sở dữ liệu bị chậm — bộ tạo (generator) viết lại truy vấn, bộ đánh giá (evaluator) chạy thử trên tập dữ liệu đại diện để kiểm tra thời gian thực thi. Điều kiện đạt: phản hồi dưới 200ms.
Cạm bẫy “Vòng lặp Vô nghĩa”
Pattern này dễ thất bại và gây lãng phí nhất khi các điều kiện thoát (exit conditions) không được định nghĩa chi tiết. Ngoài “thành công” và “chạm giới hạn số vòng lặp tối đa”, có 4 trạng thái thất bại “ẩn” mà kỹ sư thường bỏ quên:
- Không có tiến triển (No progress): Hệ thống trả về cùng một mã lỗi hoặc cùng một bản nháp lặp đi lặp lại — vòng lặp chỉ đang lấy mẫu lại (resampling) một cách vô ích.
- Dao động (Oscillation): Hệ thống nhảy từ trạng thái A, sang B, rồi quay lại A — bản sửa lỗi này lại làm hỏng thành phần khác.
- Cạn kiệt ngân sách Token: Các lần thử sau sẽ đắt đỏ hơn lần thử trước do ngữ cảnh (context) bị tích lũy dần; 10 vòng lặp không có nghĩa là chi phí chỉ gấp 10 lần vòng lặp đầu tiên.
- Chi phí tăng nhưng điểm đánh giá không đổi: Tín hiệu rõ ràng nhất cho thấy bạn đang “đốt tiền” vào bài toán mà generator không đủ khả năng giải quyết.
Best Practices
- Ghi log chi tiết từng vòng lặp: Hãy ghi lại phán quyết và lý do của bộ đánh giá ở mọi vòng lặp. Một vòng lặp phải thất bại 9 lần rồi mới qua sẽ cho bạn nhiều thông tin để tinh chỉnh hệ thống hơn là một vòng lặp thành công ngay lần đầu.
- Cô lập ngữ cảnh lỗi: Trừ khi bộ tạo thực sự cần đọc lại những nỗ lực đã thất bại để rút kinh nghiệm, hãy giữ các bản nháp hỏng ra khỏi cửa sổ ngữ cảnh của lần thử tiếp theo. Thông thường, chỉ cần truyền lại thông báo lỗi là đủ.
- Phân định rõ lý do dừng: Khi vòng lặp thoát vì chạm giới hạn số lần thử chứ không phải vì thành công, hãy xử lý nó như một trạng thái hoàn toàn riêng biệt. Các nút hạ nguồn cần phản ứng khác nhau đối với “chúng ta đã ngừng thử” so với “cách này hoàn toàn không hoạt động”.
Xu hướng mở rộng
GraphRAG: Xử Lý Ngữ Cảnh Toàn Cục
Retrieval-Augmented Generation (RAG) truyền thống dựa trên tìm kiếm vector cực kỳ hiệu quả với các truy vấn cục bộ. Tuy nhiên, nó thất bại thảm hại trước các câu hỏi yêu cầu hiểu biết toàn cục (global sensemaking) trên toàn bộ tập dữ liệu.
GraphRAG giải quyết vấn đề này bằng cách sử dụng LLM để trích xuất các thực thể và mối quan hệ, từ đó xây dựng một đồ thị tri thức phân cấp (hierarchical knowledge graph). Hai kỹ thuật tối ưu hóa đang đưa GraphRAG lên tầm cao mới:
- Dynamic Community Selection: Dùng một LLM nhỏ (như GPT-5 mini) để chấm điểm và cắt tỉa (prune) các nhánh không liên quan ngay từ sớm — giảm trung bình 77% chi phí token mà vẫn giữ nguyên chất lượng câu trả lời.
- GraphRAG-FI (Filtering & Integration): Áp dụng bộ lọc hai giai đoạn và tích hợp dựa trên phân phối xác suất (logits) để cân bằng giữa tri thức bên ngoài và khả năng tự suy luận của mô hình.
Graph Transformers: Cách Mạng Hóa Khả Năng Hiểu Đồ Thị
Việc đưa dữ liệu đồ thị vào các mô hình Transformer tiêu chuẩn từng là một bài toán khó. Các kiến trúc Graph Transformers (GTs) đã vượt qua giới hạn của mạng nơ-ron đồ thị (GNN) truyền thống:
- GraphGPT: Sử dụng kỹ thuật tuần tự hóa dựa trên các chu trình Euler để chuyển đổi đồ thị thành chuỗi token không mất mát thông tin. Mở rộng lên tới 2 tỷ tham số và đạt hiệu năng SOTA trên các tập dữ liệu OGB lớn.
- Relational Graph Transformer (RelGT): Phân rã mỗi nút thành 5 thành phần token: đặc trưng, loại, khoảng cách bước duyệt, thời gian và cấu trúc cục bộ.
- GraphTARIF: Tích hợp mô-đun mạng cục bộ để tăng hạng (rank), đồng thời dùng hàm lũy thừa lôgarit có khả năng học để làm sắc nét sự phân bổ trọng số chú ý.
Hạ Tầng: Chuẩn GQL và Graph Databases
Tháng 4/2024 đánh dấu bước ngoặt khi ISO GQL (Graph Query Language) chính thức trở thành ngôn ngữ truy vấn cơ sở dữ liệu độc lập mới đầu tiên được ISO phê chuẩn kể từ SQL năm 1987.
Khi xây dựng hạ tầng, các kỹ sư cần cân nhắc sự khác biệt về kiến trúc lưu trữ:
| Database | Kiến trúc | Điểm mạnh |
|---|---|---|
| Memgraph | In-Memory First (C++) | Độ trễ cực thấp, phân tích luồng thời gian thực |
| FalkorDB | Tích hợp trên Key-Value | Khởi động nhanh, hiệu năng có thể đạt 496x |
| TigerGraph | Native Parallel Graph | Sharding tự động, batch write siêu tốc, hàng chục tỷ đỉnh |
Tổng Kết
Graph Engineering không chỉ là một thuật ngữ “bắt trend” mới. Nó là sự công nhận rằng việc xây dựng các hệ thống AI cấp doanh nghiệp đòi hỏi sự kiểm soát nghiêm ngặt về mặt kiến trúc. Bằng cách cấu trúc hóa luồng công việc thông qua đồ thị (Agent Graph), tăng cường khả năng truy xuất bằng GraphRAG, vận dụng các Graph Transformers hiện đại và dựa trên hạ tầng GQL vững chắc, chúng ta đang bước vào một kỷ nguyên mới của Trí tuệ Nhân tạo — nơi AI không chỉ “suy nghĩ” mà còn được kiến trúc hóa để hoạt động an toàn, có kiểm soát và có thể mở rộng trong môi trường thực tế.
Bài viết tổng hợp và phân tích về xu hướng Graph Engineering trong thiết kế hệ thống AI Agent, dựa trên các thảo luận và tài liệu kỹ thuật từ cộng đồng AI giữa năm 2026.