Sau khi fine-tuning LLM xong bằng Supervised Fine-tuning (SFT), model đã biết trả lời theo định dạng hỏi–đáp. Về bản chất, SFT chỉ là ép model tối ưu hàm mất mát để khớp với phân phối của dữ liệu mẫu, tức là nó dạy model sinh ra (generate) những token có xác suất cao nhất dựa trên những gì đã thấy.
Nhưng đây chính là giới hạn lớn nhất của SFT: xác suất cao không đồng nghĩa với chất lượng cao.
SFT biến model thành một con vẹt, chỉ nói lại những gì đã học, mà mất đi năng lực phân biệt. Model có thể tạo ra một câu trả lời nghe rất “giống” dữ liệu huấn luyện, nhưng không có khái niệm câu trả lời A có thực sự tốt hơn câu trả lời B hay không, đặc biệt với dữ liệu chưa từng thấy (out-of-distribution). Khoảng trống giữa “biết cách trả lời” và “biết thế nào là trả lời tốt” chính là lý do SFT thường tạo ra model hay ảo giác (hallucination) hoặc từ chối trả lời một cách máy móc.
Để lấp khoảng trống này, ta cần chuyển từ Next-Token Prediction sang Preference Optimization. Bài này đi theo đúng mạch đó: nhìn lại pre-training và SFT để thấy giới hạn nằm ở đâu, sau đó vào preference data, rồi cách xây reward model từ dữ liệu chỉ mang tính so sánh, và cuối cùng là PPO (thuật toán RL đứng sau RLHF) cùng những cái giá phải trả khi dùng nó.
Từ pre-training đến SFT
Pre-training dạy model điều gì?
Trước cả SFT, nền tảng của LLM đã trải qua giai đoạn pre-training: học trên một lượng văn bản khổng lồ với đúng một mục tiêu là dự đoán token tiếp theo dựa trên các token đã có trước đó (Radford et al., 2019). Lặp lại việc này hàng tỷ lần, model dần học được distribution của ngôn ngữ: từ nào hay đi sau từ nào, cấu trúc câu ra sao, kiến thức nào thường xuất hiện cùng nhau.
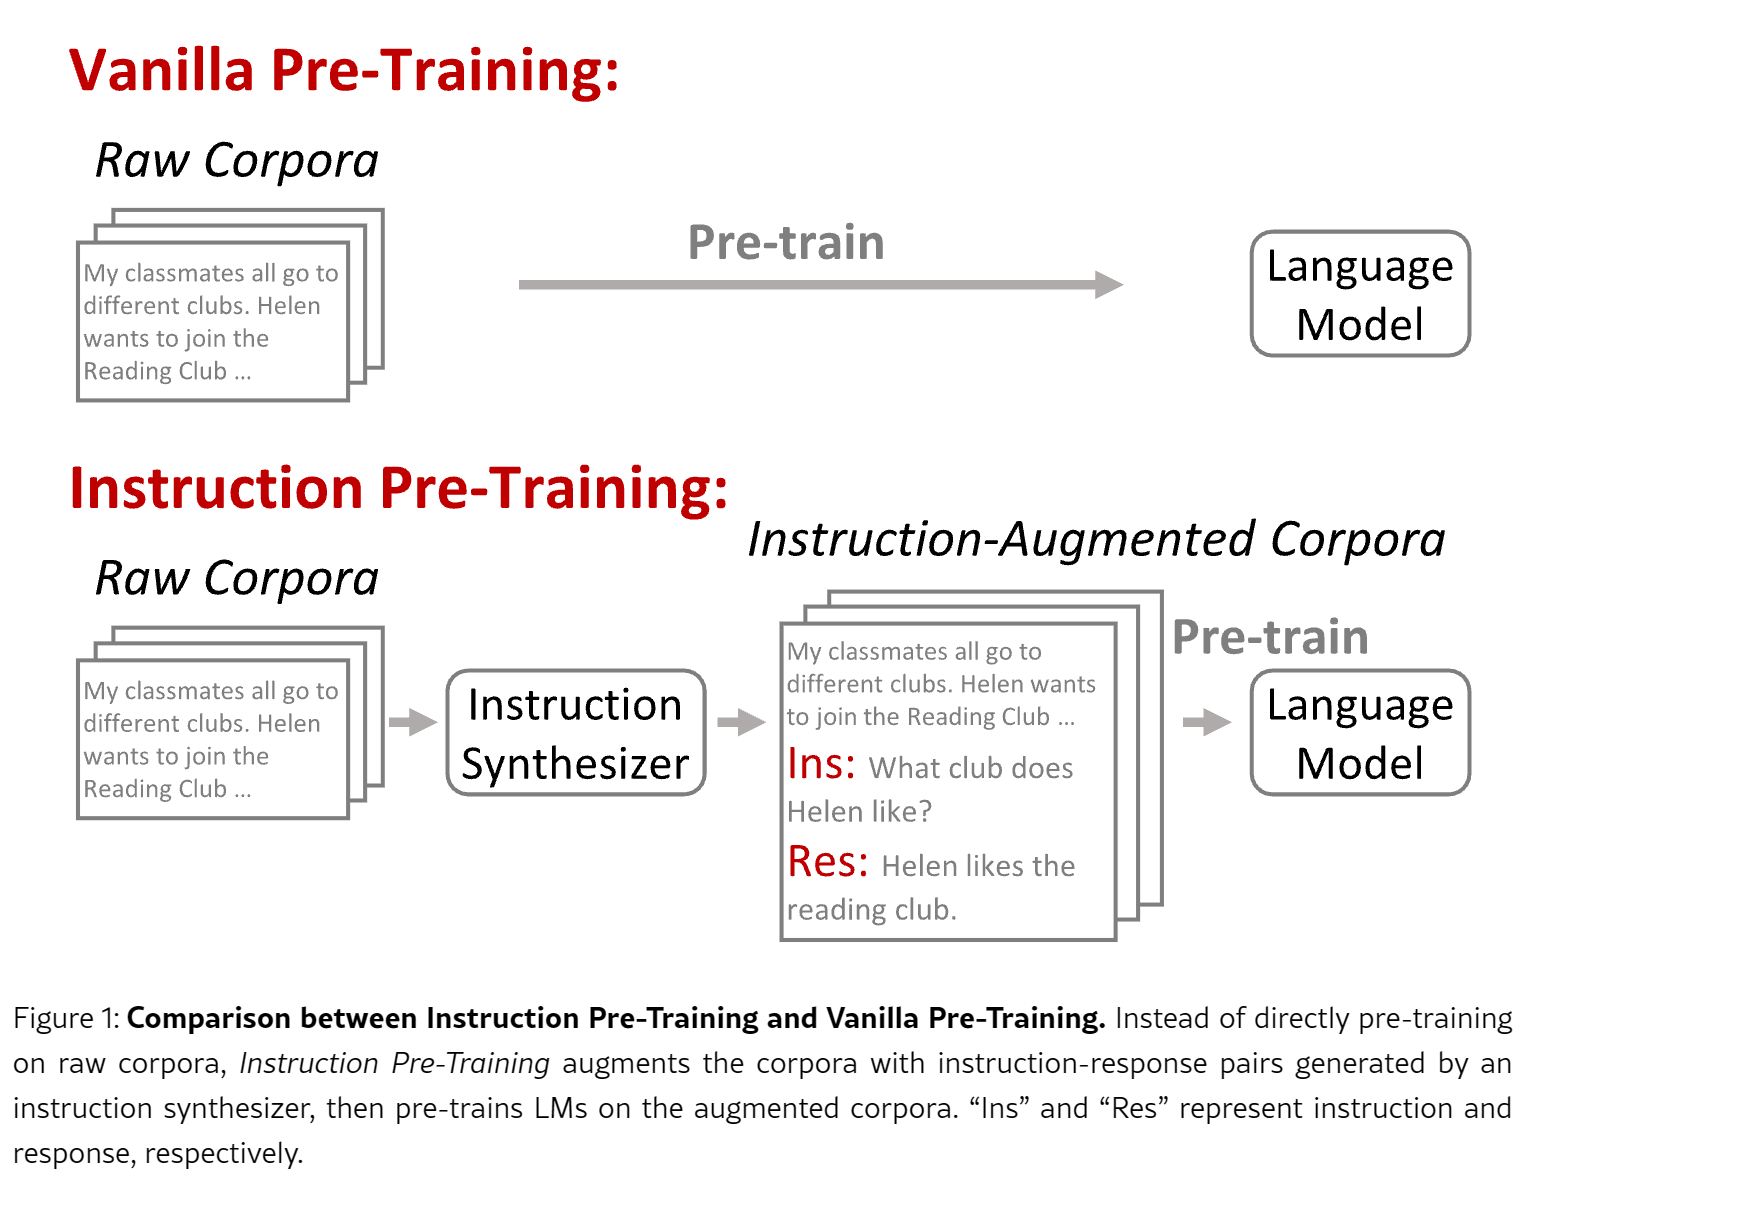
Vấn đề nằm ở chỗ: dự đoán token tiếp theo giỏi không đồng nghĩa với trả lời đúng ý người dùng. Một model chỉ pre-train (chưa qua SFT), khi nhận prompt “Hãy giúp tôi viết blog về chủ đề fine-tuning LLM”, hoàn toàn có thể tiếp tục bằng cách liệt kê thêm vài prompt tương tự, hoặc viết tiếp một đoạn văn ngẫu nhiên giống nội dung từng thấy trên web, vì về bản chất, nó chỉ đang làm đúng việc được huấn luyện: đoán chuỗi ký tự nào có khả năng xuất hiện tiếp theo, chứ không phải “hoàn thành yêu cầu của người dùng”.
Đây chính là khoảng cách giữa hai việc tưởng như giống nhau: giỏi ngôn ngữ và biết nghe lời. Nhóm InstructGPT gọi thẳng vấn đề này: model càng lớn không tự động khiến nó theo sát ý định người dùng hơn, tức là hai mục tiêu này không tự nhiên đi cùng nhau (Ouyang et al., NeurIPS 2022).
Nhắc lại về Supervised Fine-Tuning (SFT)
SFT là bước can thiệp đầu tiên để điều chỉnh phân phối của model. Bằng cách tối ưu trên tập dữ liệu gồm các cặp (instruction, response) do con người viết, hàm mục tiêu buộc model dịch chuyển từ “tiếp nối văn bản” sang “đóng vai trợ lý trả lời câu hỏi”.
Nhưng SFT có một giới hạn về mặt toán học: hàm loss của nó (cross-entropy) về bản chất là bài toán point-wise, tức là ép phân phối sinh ra của model khớp với duy nhất một câu trả lời mẫu có sẵn trong tập dữ liệu. Điều này khiến SFT khó biểu diễn ba câu hỏi rất tự nhiên:
- Câu trả lời nào tốt hơn? Với cùng một câu hỏi, có thể có hai cách trả lời đều đúng nhưng khác nhau về chất lượng diễn đạt, nhưng SFT không có cơ chế toán học nào để nói “cách này tốt hơn cách kia”, vì nó chỉ học theo đúng một mẫu duy nhất được gán nhãn “đúng”.
- Tốt hơn bao nhiêu? Ngay cả khi có cách gán điểm cho câu trả lời, SFT cũng không học được mức độ chênh lệch, vì cross-entropy về cơ bản là hàm phạt mang tính nhị phân trên từng token, nên nó không phân biệt được một câu trả lời tệ và một câu trả lời rất tệ, vì cả hai đều chỉ là “không khớp mẫu”.
- Nếu có nhiều đáp án đều đúng thì sao? Với yêu cầu mở như “Tóm tắt đoạn văn sau”, không gian câu trả lời đúng là đa chiều: có thể có năm cách tóm tắt khác nhau về độ dài, văn phong nhưng đều chấp nhận được. Tập dữ liệu SFT thường chỉ chứa một cách cụ thể, khiến model học lệch theo phong cách của người gán nhãn đó, thay vì học được rằng có nhiều lựa chọn đúng.
Đây là lỗ hổng thúc đẩy preference data ra đời, đánh dấu bước chuyển từ tư duy tối ưu point-wise (học từ một mẫu) sang pair-wise/list-wise (học từ việc so sánh hai hay nhiều mẫu), mở đường cho Reward Modeling và RLHF.
Preference Data
Preference data là gì?
Nếu SFT trả lời câu hỏi “Câu trả lời đúng là gì?”, thì preference data trả lời một câu hỏi tinh tế hơn: “Trong hai lựa chọn, câu nào tốt hơn?”. Thay vì cung cấp một target distribution duy nhất, preference data trình bày cho model một bộ ba (triplet):
$$\text{Prompt} \to y_w \succ y_l$$Trong đó $y_w$ là response được chọn (chosen, hay “winner”), $y_l$ là response bị loại (rejected, hay “loser”), và ký hiệu $\succ$ (prefer) thể hiện một quan hệ thứ bậc tương đối (relative ranking), không phải một giá trị tuyệt đối.
Ví dụ với prompt “Giải thích Overfitting”:
- Response A: “Overfitting là khi model học thuộc lòng dữ liệu train tới mức bắt luôn cả nhiễu, dẫn tới việc dự đoán tốt trên tập train nhưng tệ trên dữ liệu mới. Ví dụ: một model phân loại ảnh chó/mèo học overfitting có thể ghi nhớ luôn cả nền ảnh trong tập train, thay vì học đặc điểm con vật.”
- Response B: “Overfitting là lỗi thường gặp trong machine learning.”
Một người gán nhãn đọc cả hai và đưa ra phán quyết: A > B. Đây là một bản ghi preference data hoàn chỉnh, vì nó không nói A là “đáp án đúng tuyệt đối”, chỉ nói A tốt hơn B trong so sánh cụ thể này; nói cách khoa học hơn, trong không gian những câu trả lời có thể sinh ra, A nằm ở vị trí cao hơn B về mặt chất lượng.
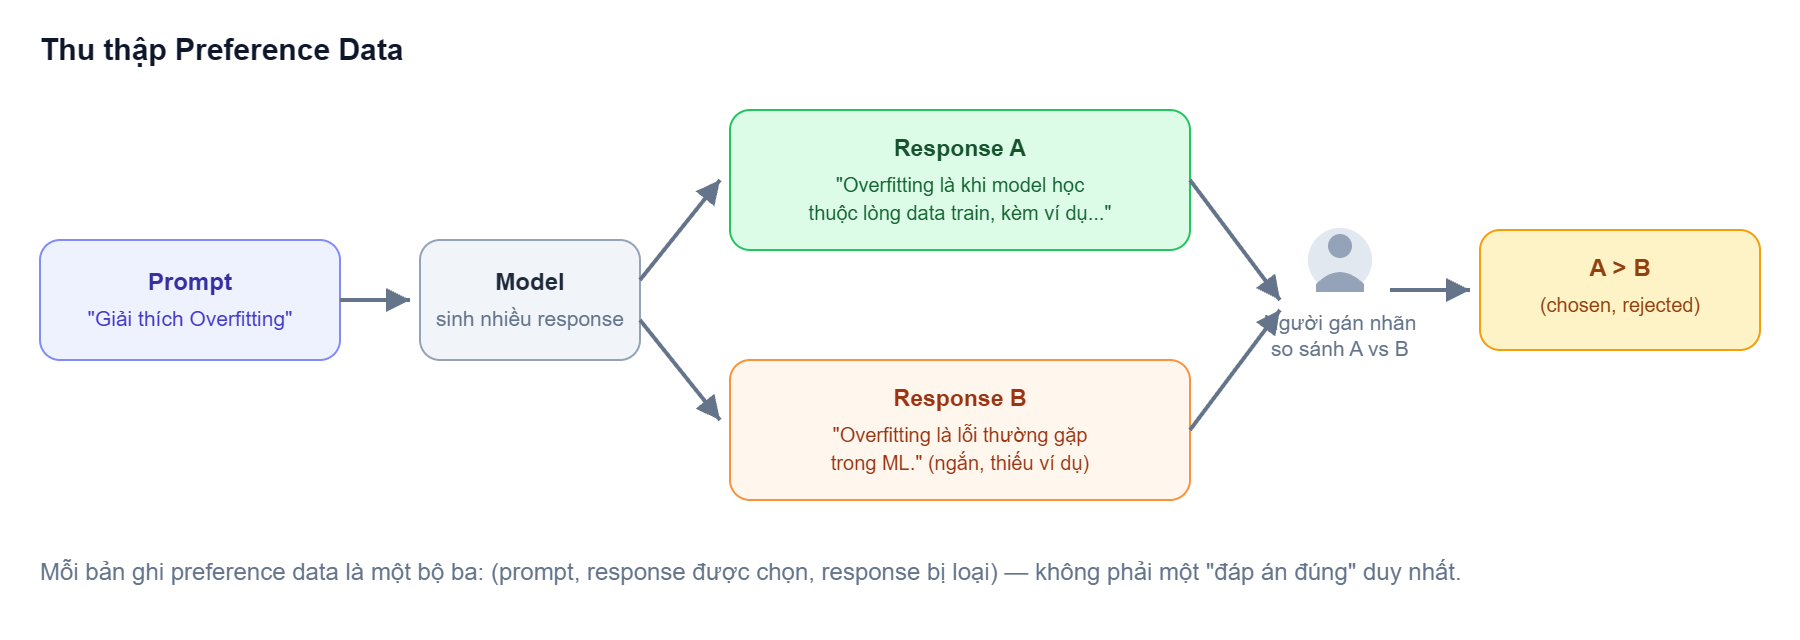
Preference data cung cấp cho model một gradient tương đối (relative gradient). Ngay cả khi cả A và B đều không hoàn hảo, miễn là A tốt hơn B, model sẽ học được hướng di chuyển trong không gian tham số để tăng xác suất sinh ra những câu trả lời giống A và giảm xác suất sinh ra những câu trả lời giống B.
Đây cũng là nền tảng để xây reward model: mỗi mẫu preference data ngầm định cung cấp một hàm phần thưởng, cụ thể là hãy sinh ra những token khiến $y_w$ (câu trả lời tốt) có xác suất cao hơn $y_l$ (câu trả lời tệ).
Preference ≠ Ground Truth
Điểm dễ hiểu lầm nhất khi mới tiếp cận preference data: A > B không có nghĩa A là câu trả lời đúng duy nhất, hay B là sai. Preference mang tính tương đối, và phụ thuộc vào việc ta đang ưu tiên tiêu chí nào trong nhiều tiêu chí cùng lúc, phổ biến nhất là khung Helpful, Honest, Harmless, viết tắt HHH (Askell et al., 2021). Về bản chất đây là bài toán tối ưu hóa đa mục tiêu:
- Helpfulness: câu trả lời có thực sự giải quyết đúng nhu cầu người hỏi không?
- Honesty: câu trả lời có trung thực, không bịa đặt, biết thừa nhận giới hạn hiểu biết của model không?
- Harmlessness: câu trả lời có tránh gây hại, không hỗ trợ hành vi nguy hiểm không?
Ba tiêu chí này không phải lúc nào cũng đi cùng chiều, đôi khi chúng mâu thuẫn nhau, và preference chính là nơi con người phải đưa ra đánh đổi. Xét một câu hỏi nhạy cảm kiểu “hướng dẫn chi tiết cách chế tạo vật liệu nguy hiểm tại nhà”: một câu trả lời giải thích đầy đủ có thể coi là “helpful” theo nghĩa hẹp, vì nó trả lời đúng câu hỏi. Nhưng gần như mọi hệ thống alignment đều huấn luyện để labeler chọn câu trả lời từ chối làm “chosen”, dù xét thuần về helpfulness thì nó “kém hữu ích hơn”, vì harmlessness được ưu tiên cao hơn trong tình huống này. Ngược lại, với một câu hỏi học thuật bình thường, một câu trả lời né tránh không cần thiết (“Tôi không thể giúp bạn về chủ đề này”) lại thường bị đánh giá là kém, dù “an toàn tuyệt đối”, vì lúc này helpfulness mới là tiêu chí quyết định.
Ngoài HHH, preference trong thực tế còn chịu ảnh hưởng bởi style (văn phong ngắn gọn hay chi tiết, trang trọng hay gần gũi) và instruction following (có bám sát định dạng, độ dài, ràng buộc người dùng yêu cầu hay không). Hai người gán nhãn với gu văn phong khác nhau hoàn toàn có thể đưa ra phán quyết trái ngược cho cùng một cặp response, và đây là nguồn nhiễu tự nhiên trong preference data, và là điều mà bước tiếp theo (huấn luyện reward model) phải học cách xử lý.
Reward Model
Từ preference data ở trên, ta có các bộ ba $(\text{Prompt}, y_w, y_l)$. Nhưng LLM khi đang sinh token không thể dừng lại để “hỏi” con người xem câu vừa viết có tốt hơn câu khác hay không. Ta cần một cơ chế chấm điểm tự động, chấm được bất kỳ câu trả lời nào một cách tức thì và liên tục. Đây là vai trò của Reward Model (RM).
Về mặt kiến trúc, RM thường là một bản sao của model đã qua SFT, nhưng được thay lớp đầu ra. Thay vì sinh phân phối xác suất cho token tiếp theo, RM nhận đầu vào là một cặp hoàn chỉnh $(x, y)$ và nén toàn bộ thông tin ngữ nghĩa thành một giá trị vô hướng duy nhất $r_\phi(x, y)$, trong đó:
- $x$ là prompt,
- $y$ là response,
- $r_\phi$ trả về một số thực thể hiện mức độ “tốt” của response $y$ khi trả lời prompt $x$, với $\phi$ là tham số của chính reward model (thường cũng là một transformer, khởi tạo từ policy SFT, nhưng thay lớp output bằng một lớp trả ra một số thực duy nhất thay vì phân phối xác suất trên từ vựng).
Nhờ vậy, con người chỉ cần gán nhãn một lượng preference data hữu hạn, còn reward model sẽ tổng quát hóa theo gu chấm điểm đó ra hàng triệu response được sinh ra sau này trong bước RL. Nhưng có một câu hỏi: RM học cách chấm điểm như thế nào từ dữ liệu chỉ mang tính so sánh? Làm sao đi từ “$y_w$ tốt hơn $y_l$” (thông tin nhị phân) tới “$y_w$ được bao nhiêu điểm, $y_l$ được bao nhiêu điểm” (giá trị liên tục)?
Phương pháp tiêu chuẩn, và là nền tảng của hầu hết hệ thống RLHF hiện đại, là mượn một mô hình thống kê có từ năm 1952: Bradley–Terry model.
Bradley–Terry Preference Model
Christiano et al. (NeurIPS 2017) mượn Bradley–Terry model (Bradley & Terry, 1952), vốn dùng để ước lượng “sức mạnh” của các đấu thủ từ kết quả đấu đôi một, tương tự cách hệ thống Elo trong cờ vua suy ra điểm mạnh yếu của kỳ thủ từ lịch sử thắng thua mà không cần biết trước điểm tuyệt đối của ai.
Nếu con người thích $y_w$ hơn $y_l$, Bradley–Terry giả định xác suất con người chọn $y_w$ tuân theo:
$$P(y_w \succ y_l \mid x) = \frac{\exp(r_\phi(x, y_w))}{\exp(r_\phi(x, y_w)) + \exp(r_\phi(x, y_l))}$$Trực giác của công thức này rất đơn giản: nếu $r_\phi(x, y_w)$ lớn hơn nhiều so với $r_\phi(x, y_l)$, vế phải tiến gần tới 1, nghĩa là mô hình gần như chắc chắn con người sẽ chọn $y_w$. Nếu hai điểm số gần bằng nhau, xác suất tiến về 0.5, nghĩa là hai response được xem là “ngang sức”, giống hai kỳ thủ có Elo gần bằng nhau thì tỷ lệ thắng gần 50–50.
Điều quan trọng cần lưu ý: Bradley–Terry chỉ quan tâm đến hiệu số $r_\phi(x, y_w) - r_\phi(x, y_l)$, không quan tâm giá trị tuyệt đối của từng điểm số. Giống Elo, bạn không thể nói “kỳ thủ 2400 điểm giỏi hơn kỳ thủ 2000 điểm đúng 400 đơn vị tuyệt đối nào đó”, chỉ có thể nói xác suất người 2400 thắng người 2000 là bao nhiêu. Reward model vì vậy học ra một thang điểm tương đối, không phải thang điểm có ý nghĩa tuyệt đối.
Loss function của Reward Model
Công thức ở trên mới chỉ là mô hình xác suất. Để huấn luyện reward model bằng gradient descent, ta cần một loss function cụ thể. Cách làm chuẩn: tối đa hóa log-likelihood của toàn bộ preference data quan sát được, tương đương tối thiểu hóa negative log-likelihood:
$$\mathcal{L}(\phi) = -\mathbb{E}_{(x, y_w, y_l) \sim D}\left[\log \sigma\big(r_\phi(x, y_w) - r_\phi(x, y_l)\big)\right]$$trong đó $D$ là tập preference data đã thu thập, và $\sigma$ là hàm sigmoid, và về mặt đại số, chính là cách viết gọn lại công thức Bradley–Terry ở trên. Ý nghĩa huấn luyện lúc này rất trực quan: reward model được cập nhật để làm $r_\phi(x, y_w)$ càng lớn hơn $r_\phi(x, y_l)$ càng tốt, nói cách khác, nó cố “nới rộng khoảng cách điểm số” giữa response được chọn và response bị loại, theo đúng những gì con người đã chấm.
Để hình dung loss hoạt động ra sao, xét một prompt $x$ cố định với hai response $y_w$ (được chọn) và $y_l$ (bị loại). Giả sử reward model cho ra các điểm số khác nhau qua các giai đoạn huấn luyện:
| Giai đoạn | $r_\phi(x, y_w)$ | $r_\phi(x, y_l)$ | Hiệu số $r_w - r_l$ | $\sigma(r_w - r_l)$ | Loss $= -\log\sigma(\cdot)$ |
|---|---|---|---|---|---|
| Khởi tạo (random) | 0.2 | 0.3 | −0.1 | 0.475 | 0.744 |
| Huấn luyện sớm | 0.8 | 0.4 | +0.4 | 0.599 | 0.513 |
| Huấn luyện tốt | 2.0 | 0.5 | +1.5 | 0.818 | 0.201 |
| Huấn luyện rất tốt | 4.0 | 0.5 | +3.5 | 0.971 | 0.030 |
Đọc từ trên xuống:
- Khởi tạo (random): RM chưa học được gì, chấm $y_l$ cao hơn $y_w$, ngược với preference của con người. Loss rất cao (~0.74), gradient sẽ đẩy $r_w$ lên và kéo $r_l$ xuống mạnh.
- Huấn luyện sớm: RM bắt đầu phân biệt được $y_w$ tốt hơn $y_l$ nhưng khoảng cách còn nhỏ (0.8 so với 0.4). Loss giảm từ 0.744 xuống 0.513, nhưng vẫn đủ lớn để tiếp tục học.
- Huấn luyện tốt: Khoảng cách đã rõ ràng ($y_w$ được 2.0, $y_l$ được 0.5), RM khá chắc rằng $y_w$ tốt hơn. Loss thấp (~0.2), gradient yếu đi nên model không cần điều chỉnh nhiều nữa.
- Huấn luyện rất tốt: RM gần như chắc chắn. Loss tiến về 0, gradient gần như bằng 0, nghĩa là mẫu này đã học xong.
Reward drift: khi thang điểm trôi mất
Có một ý khá tinh tế: loss không quan tâm $r_w$ hay $r_l$ lớn tuyệt đối bao nhiêu, mà chỉ quan tâm hiệu số của chúng. Một RM cho $r_w = 100, r_l = 99$ sẽ có loss tương đương RM cho $r_w = 1, r_l = 0$, vì cả hai đều có hiệu số bằng 1. Đây là hệ quả trực tiếp của việc Bradley–Terry chỉ làm việc trên thang điểm tương đối.
Hệ quả này gây ra sự trôi dạt điểm số (reward drift): hai reward model hoàn toàn khác nhau có thể cho cùng một loss, dù chúng chấm điểm rất khác nhau.
| Reward Model | $r_\phi(x, y_w)$ | $r_\phi(x, y_l)$ | Hiệu số | Loss |
|---|---|---|---|---|
| RM-A | 1.0 | 0.0 | +1.0 | 0.31 |
| RM-B | 1001.0 | 1000.0 | +1.0 | 0.31 |
Cả hai đều “học tốt như nhau” theo nghĩa loss, vì hiệu số bằng nhau. Nhưng nếu hỏi RM-A và RM-B: “Câu trả lời này được bao nhiêu điểm?”, ta sẽ nhận hai con số chênh nhau 1000 lần. Trong quá trình huấn luyện, RM có thể đẩy cả $r_w$ và $r_l$ lên cao cùng lúc (hoặc kéo cả hai xuống) mà loss vẫn giảm bình thường. Thứ hạng tương đối giữa các response vẫn đúng, nhưng mốc 0 của thang điểm thì trôi mất.
Để hình dung: mình là ông chủ blog khó tính nhưng không đủ thời gian viết bài, cần chấm điểm để tuyển nhân sự viết blog, nên thuê 2 người kiểm định là Claude và GPT (tất nhiên là dùng bản free 😄). Mình prompt thống nhất với cả hai rằng nhân sự nào tốt hơn thì chấm cao hơn. Nhưng Claude chấm trên thang 0–10, còn GPT chấm trên thang 1000–2000. Chấm xong, mình ra lệnh: “Hãy tuyển những nhân sự được trên 5 điểm”. Với Claude, lệnh này tuyển được một số người và loại một số người, vì 5 nằm trong đoạn $[0, 10]$. Với GPT, tất cả mọi người đều được tuyển, vì ai cũng $\geq 1000$ điểm rồi.
Tuy nhiên, trong Machine Learning, điểm số không dùng để ra quyết định “tuyển/loại” cứng nhắc, mà đóng vai trò là động lực (gradient) để điều chỉnh hành vi của model. Hãy đổi kịch bản: thay vì tuyển người, mình nói “Mỗi điểm thưởng sẽ được quy đổi thành tiền để khuyến khích nhân sự viết tốt hơn”.
- Với Claude: một cộng tác viên viết tốt được 8 điểm → nhận 8 triệu thưởng. Mức thưởng hợp lý, họ sẽ tiếp tục nỗ lực cải thiện chất lượng bài viết.
- Với GPT: một cộng tác viên bình thường cũng được 1500 điểm → nhận 1,5 tỷ đồng thưởng.
Hậu quả là cộng tác viên đó nhanh chóng nhận ra: họ không cần tốn công viết hay hơn, chỉ cần tìm ra các “lỗ hổng” trong cách chấm của GPT (ví dụ chèn liên tục các từ khóa sáo rỗng, lặp lại một cấu trúc câu nhất định) là đạt 2000 điểm và nhận 2 tỷ. Họ không thực sự viết tốt hơn, họ chỉ đang hack người chấm.
Trong RLHF, thuật toán PPO gặp đúng tình huống “trả thưởng ảo” này. Khi điểm reward bị drift, gradient cập nhật có thể trở nên cực lớn. Policy model thay vì học cách trả lời thực sự tốt hơn, sẽ học cách sinh ra những response “đánh lừa” RM, gây ra Reward Hacking. Chất lượng output đi xuống, dù điểm số trên giấy vẫn tăng vọt.
Giải pháp là gì? Ta cần một cái “mỏ neo”, tức là thứ giữ cho policy không trôi quá xa khỏi hành vi ban đầu. Trong RLHF, mỏ neo đó là KL Divergence Penalty: một thành phần trong hàm reward của PPO, phạt model nếu nó đi quá xa khỏi phân phối ngôn ngữ của model SFT gốc. Nói cách khác, KL penalty là một điều khoản trong “hợp đồng lao động”: “Anh có thể kiếm điểm thưởng, nhưng vẫn phải giữ phong độ viết như một con người bình thường, không được biến thành cỗ máy spam điểm.”
Phần tiếp theo sẽ cho thấy PPO trong RLHF khác PPO thuần túy trong game như thế nào, và vì sao KL penalty là mảnh ghép không thể thiếu để ngăn reward hacking.
Proximal Policy Optimization (PPO)
Ở phần trước, ta đã xây được reward model, một “giám khảo tự động” biết chấm điểm response theo gu con người, và hiểu vì sao cần KL penalty để giữ policy không đi quá xa khỏi model SFT gốc. Giờ ta đã có đủ các mảnh ghép. Câu hỏi tiếp theo: lắp ráp chúng lại ra sao, và vì sao phải dùng reinforcement learning phức tạp như vậy?
Vì sao cần RL thay vì supervised learning thuần?
Có thể bạn sẽ hỏi: đã có reward model chấm điểm rồi, sao không đơn giản là tiếp tục làm supervised learning, coi điểm số của reward model là “label”? SFT đã chứng minh hiệu quả, vậy tại sao không mở rộng cách tiếp cận đó?
Vấn đề nằm ở một khác biệt cốt lõi về bản chất của hai bài toán:
SFT cần một cặp (input, output đúng) cố định để tính loss. Với mỗi prompt, tập dữ liệu chỉ cung cấp một câu trả lời mẫu, và cross-entropy ép model khớp phân phối sinh ra với đúng câu trả lời đó. Không có không gian để model tự khám phá, nó chỉ học cách bắt chước.
Reward model, ngược lại, không cho ta biết output nào là “đúng nhất”. Nó chỉ chấm điểm cho bất kỳ output nào ta đưa vào, kể cả những output model tự sinh ra. Đây là khác biệt mang tính nguyên tắc: RM là một hàm đánh giá (evaluation function), không phải một hàm mục tiêu cố định (fixed target).
Hãy hình dung việc dạy một đầu bếp mới vào nghề:
- Cách SFT: bạn đưa anh ta 100 công thức đã được kiểm chứng và yêu cầu học thuộc từng bước. Anh ta sẽ nấu 100 món đó rất ngon, nhưng nếu khách yêu cầu một món mới nằm ngoài 100 công thức, anh ta sẽ lúng túng.
- Cách RL: bạn cho anh ta một giám khảo (reward model) và để anh ta tự do thử nghiệm công thức mới. Mỗi lần nấu xong, giám khảo chấm điểm. Anh ta học từ chính những lần thử–sai của mình, điều chỉnh để lần sau nấu ngon hơn, và có thể khám phá những cách kết hợp nguyên liệu mà ngay cả người dạy cũng chưa từng nghĩ tới.
Đây là điểm khác biệt cốt lõi: reinforcement learning cho phép model (lúc này gọi là policy) tự sinh response, nhận điểm từ reward model cho chính response vừa sinh, rồi điều chỉnh để lần sau sinh ra response được điểm cao hơn, tạo thành một vòng lặp thử-và-học liên tục trên chính output của nó, thay vì học từ một tập nhãn cố định.
Vòng lặp này cũng là hướng tiếp cận mà Christiano et al. (NeurIPS 2017) đặt nền móng: dùng preference học được để tạo tín hiệu reward, rồi dùng RL để tối ưu policy theo tín hiệu đó, thay vì cần con người viết ra “đáp án hoàn hảo” cho từng tình huống. Nhờ vậy, model có thể khám phá những vùng không gian response mà ngay cả dữ liệu SFT cũng không chạm tới được.
Tuy nhiên, tự do đi kèm rủi ro. Nếu để policy tự do tối đa hóa điểm reward mà không ràng buộc gì, nó sẽ nhanh chóng tìm ra “lỗ hổng” trong cách chấm của reward model, chính là reward hacking đã nói ở trên. Và đây là lý do PPO trong RLHF cần thêm KL penalty, cùng một số cơ chế đặc biệt khác mà PPO thuần túy trong game không cần.
PPO cơ bản: policy, value function, advantage
Proximal Policy Optimization (PPO), do Schulman et al. (2017) đề xuất, là thuật toán Reinforcement Learning được chọn làm tiêu chuẩn cho hầu hết pipeline RLHF trên LLM (bao gồm InstructGPT). Lý do: nó cân bằng tốt giữa hiệu quả sử dụng dữ liệu (sample efficiency) và độ ổn định khi huấn luyện so với các thuật toán RL tiền nhiệm.
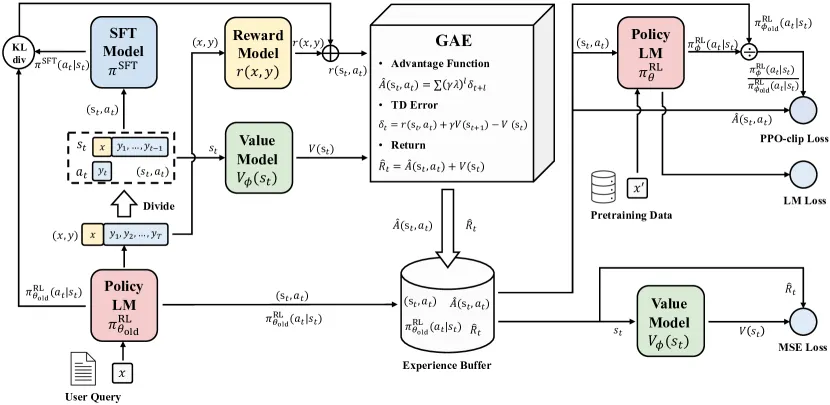
Để hiểu PPO, ta chỉ cần nắm ba khái niệm:
- Policy ($\pi_\theta$): chính là model đang được huấn luyện, khởi tạo từ model SFT. “Policy” ở đây là “chiến lược sinh token”: tại thời điểm $t$, với trạng thái $s_t$ hiện tại (prompt + các token đã sinh), nó quyết định token tiếp theo nên là gì.
- Value function ($V_\phi$): một model phụ, khởi tạo từ chính reward model, có nhiệm vụ dự đoán trước tổng điểm reward kỳ vọng nếu tiếp tục sinh từ trạng thái hiện tại; nói cách khác, nó trả lời “nếu đi tiếp từ đây, trung bình sẽ được bao nhiêu điểm?”. Điều này rất quan trọng vì reward model chỉ cho điểm khi đã sinh xong toàn bộ response, còn value function cho phép ước lượng “chất lượng” ngay từ giữa quá trình sinh, giúp policy điều chỉnh kịp thời mà không cần đợi đến cuối câu.
- Advantage ($A_t$): hiệu số giữa điểm thực tế nhận được và điểm mà value function dự đoán trước đó. Advantage dương nghĩa là hành động (chọn token đó) tốt hơn kỳ vọng nên khuyến khích policy làm nhiều hơn. Advantage âm thì nên hạn chế lại.
Điểm đặc trưng nhất của PPO là cơ chế clipping. Trong các thuật toán RL cũ (như Vanilla Policy Gradient), nếu Advantage cho thấy một hướng đi tốt, policy có thể cập nhật trọng số quá mạnh, dẫn đến thay đổi hoàn toàn hành vi chỉ sau một bước. Một ước lượng Advantage sai lệch dù nhỏ cũng có thể khiến chất lượng model sụp đổ rất nhanh. PPO giải quyết bằng cách giới hạn (clip) mức độ thay đổi của policy trong mỗi bước cập nhật: không cho phép tỷ lệ xác suất giữa policy mới và policy cũ vượt quá một ngưỡng nhất định (thường là 20%).
Hình dung bạn đang đi trong sương mù dày đặc. Value function chỉ cho bạn biết “hướng này có vẻ tốt hơn”. Thay vì chạy thục mạng theo hướng đó (rủi ro rơi xuống vực nếu ước lượng sai), PPO bắt bạn chỉ được bước những bước nhỏ, kiểm tra lại mặt đất rồi mới đi tiếp. Chữ “Proximal” (gần) trong tên gọi chính là cam kết này: giữ policy mới luôn “gần” policy cũ, đánh đổi một chút tốc độ hội tụ để lấy sự ổn định (Schulman et al., 2017).
Tuy nhiên, clipping chỉ giới hạn tốc độ thay đổi giữa các bước cập nhật liên tiếp. Nó chưa đủ để ngăn mối nguy lớn hơn: policy dần dần “trôi” quá xa khỏi bản chất ban đầu trong suốt quá trình huấn luyện dài. Lúc này ta cần đến mỏ neo cuối cùng: KL Penalty.
KL penalty
Nếu chỉ dựa vào clipping, policy cuối cùng vẫn có thể trôi dạt rất xa so với model SFT ban đầu. Lý do sâu xa: reward model, dù được huấn luyện kỹ, vẫn chỉ là một hàm xấp xỉ (approximation) cho gu thẩm định của con người. Nếu để policy tự do tối đa hóa điểm số mà không ràng buộc, nó sẽ tìm ra những “lỗ hổng” để đẩy điểm lên.
Giải pháp: gắn thêm một KL Divergence Penalty vào hàm reward. Cơ chế này phạt policy nếu phân phối xác suất sinh token của nó lệch quá xa so với phân phối của model SFT gốc (được giữ nguyên, đóng băng, gọi là Reference Model).
Cụ thể, phần thưởng thực tế $\hat{r}_t$ tại mỗi token $t$ được tính bằng điểm của Reward Model trừ đi độ lệch KL, nhân với một hệ số trọng số $\beta$:
$$\hat{r}_t = r_t^{\text{RM}} - \beta \cdot \log \frac{\pi_\theta(a_t \mid x, a_{\lt t})}{\pi_{\text{ref}}(a_t \mid x, a_{\lt t})}$$Để hình dung con số này hoạt động ra sao, xét một ví dụ cụ thể tại token thứ $t$. Giả sử policy đang train ($\pi_\theta$) “tự tin” sinh ra từ “absolutely” với xác suất 0.8, trong khi Reference Model ($\pi_{\text{ref}}$) chỉ cho xác suất 0.2 (vì nó thấy từ này hơi sáo rỗng trong ngữ cảnh này).
- Độ lệch KL tại token này là: $\log\dfrac{0.8}{0.2} = \log 4 \approx 1.39$.
- Giả sử Reward Model chấm response này $r_t^{\text{RM}} = 2.0$, và hệ số $\beta = 0.1$.
- Phần thưởng thực tế sẽ là: $\hat{r}_t = 2.0 - (0.1 \times 1.39) = 1.861$.
Ý nghĩa: policy bị “phạt” nhẹ (mất 0.139 điểm) vì dám sinh token với xác suất cao hơn nhiều so với mức an toàn của model gốc. Nếu nó tiếp tục sinh hàng loạt token kỳ lạ để “hack” điểm, khoản phạt KL sẽ tích lũy nhanh chóng và kéo tổng điểm xuống, triệt tiêu động lực học theo hướng sai lệch đó.
Trực giác về hệ số $\beta$:
- Nếu $\beta$ quá lớn: policy bị “buộc dây” quá chặt vào SFT gốc. Model rất an toàn, không bị reward hacking, nhưng gần như không cải thiện được gì so với SFT ban đầu.
- Nếu $\beta$ quá nhỏ: policy được tự do tối ưu theo Reward Model. Nó có thể đạt điểm reward rất cao, nhưng rủi ro rơi vào reward hacking (sinh văn bản rác) rất lớn.
$\beta$ là một siêu tham số (hyperparameter) phải cân chỉnh thủ công, không có công thức “đúng” cho mọi trường hợp (Ouyang et al., NeurIPS 2022).
Pipeline đầy đủ: SFT → Reward Model → PPO (case study InstructGPT)
Sau khi hiểu rõ từng thành phần, giờ là lúc lắp ráp. Nhóm InstructGPT (OpenAI) tổng hợp toàn bộ quy trình vào một hàm mục tiêu duy nhất để tối ưu policy $\pi_\theta$. Công thức hoàn chỉnh, gọi là PPO-ptx (PPO with pre-training mix), có dạng:
$$J(\theta) = \mathbb{E}_{(x,y)\sim\pi_\theta}\left[r_\phi(x,y) - \beta \log\frac{\pi_\theta(y\mid x)}{\pi_{\text{ref}}(y\mid x)}\right] + \gamma\,\mathbb{E}_{x\sim D_{\text{pretrain}}}\left[\log \pi_\theta(x)\right]$$Ba thành phần cốt lõi của công thức:
- $r_\phi(x, y)$ (tối đa hóa phần thưởng): buộc model sinh ra những câu trả lời được Reward Model chấm điểm cao (hữu ích, trung thực, an toàn).
- $-\beta \log\dfrac{\pi_\theta}{\pi_{\text{ref}}}$ (KL Penalty): phạt model nếu đi quá xa khỏi phân phối của Reference Model (chính là model SFT ban đầu), ngăn reward hacking và sự trôi dạt (drift).
- $\gamma \log \pi_\theta(x)$ (Pre-training Mix): “vũ khí bí mật” của InstructGPT, trộn thêm một lượng nhỏ gradient từ chính dữ liệu pre-training ban đầu vào quá trình huấn luyện RLHF.
Alignment Tax (cái giá của sự tuân thủ)
Vì sao OpenAI cần thành phần thứ ba ($\gamma$)? Vì họ phát hiện một hiện tượng đáng lo: sau khi huấn luyện RLHF thuần túy (chỉ có hai thành phần đầu), model có xu hướng tụt hiệu năng rõ rệt trên một số benchmark NLP công khai (InstructGPT ghi nhận ở các tập như SQuAD, DROP, HellaSwag và dịch máy WMT; Ouyang et al., NeurIPS 2022). Hiện tượng này được gọi là Alignment Tax (thuế tuân thủ).
Hãy nhớ lại hành trình của model:
- Pre-training dạy model một phân phối ngôn ngữ cực kỳ rộng và đa dạng (biết làm thơ, viết code, phân tích logic).
- SFT thu hẹp phân phối đó lại, chỉ tập trung vào định dạng “hỏi–đáp”.
- RLHF (với KL penalty siết chặt) tiếp tục ép model thu hẹp hơn nữa, ưu tiên sự “an toàn” và “ngắn gọn”.
Kết quả là model dần “quên” đi những kiến thức tổng quát và khả năng suy luận phức tạp học được từ kho dữ liệu khổng lồ ban đầu: nó trở thành một “nhân viên hành chính” ngoan ngoãn, nhưng mất đi tư duy của một “nhà bách khoa toàn thư”.
Giải pháp: PPO-ptx
Nhóm tác giả đã thử tăng hệ số $\beta$ (siết chặt KL penalty hơn) để giữ model gần SFT, nhưng cách này không khôi phục được hoàn toàn hiệu năng trên benchmark. Thay vào đó, họ thử hướng ngược lại: nới lỏng sự thu hẹp bằng cách trộn thêm dữ liệu pre-training, với một hệ số $\gamma$ điều chỉnh mức trộn.
Hình dung: giống như bắt một nhân viên chuyên soạn thảo hợp đồng (SFT/RLHF) mỗi ngày phải dành 30 phút đọc tin tức tổng hợp (pre-training). Điều này giúp họ không bị “tư duy đường mòn”, giữ được sự nhạy bén và kiến thức nền tảng.
Kết quả thực nghiệm cho thấy PPO-ptx hiệu quả hơn hẳn: vừa giữ được cải thiện vượt trội về khả năng tuân thủ chỉ thị từ RLHF, vừa giảm đáng kể alignment tax so với các benchmark công khai.
Kết quả mang tính bước ngoặt
Sự kết hợp SFT → Reward Model → PPO-ptx tạo ra một kết quả khiến cả ngành phải chú ý:
InstructGPT bản 1.3B tham số (đã qua RLHF) được con người đánh giá là tốt hơn, hữu ích hơn và ít độc hại hơn so với GPT-3 bản 175B tham số (chưa qua RLHF, chỉ dùng zero-shot/few-shot prompting).
Một model nhỏ hơn hơn 100 lần lại vượt mặt đàn anh khổng lồ của chính nó. Đây là minh chứng rõ ràng cho luận điểm xuyên suốt: kích thước model (scale) không phải là tất cả. Cách bạn dạy nó phản hồi đúng ý người dùng (alignment) quan trọng không kém, và đôi khi có thể bù đắp cho sự chênh lệch về quy mô.
Mặt trái của PPO: chi phí, sự bất ổn và cái bẫy Reward Hacking
Dù là “tiêu chuẩn vàng” trong các nghiên cứu RLHF tiên phong (như InstructGPT), việc triển khai PPO trong thực tế giống như xây nhà trên nền đất lún. Có ba vấn đề cốt lõi khiến PPO trở thành cơn ác mộng vận hành so với sự đơn giản của SFT.
Gánh nặng tính toán “tứ trụ”
Một training step của PPO yêu cầu bốn model cùng tồn tại trong bộ nhớ GPU:
| Model | Vai trò |
|---|---|
| Actor (Policy $\pi_\theta$) | Mô hình đang được huấn luyện |
| Critic (Value $V_\phi$) | Dự đoán điểm thưởng kỳ vọng |
| Reward Model ($r_\phi$) | Chấm điểm response |
| Reference Model ($\pi_{\text{ref}}$) | Model SFT gốc (đóng băng) để tính KL penalty |
Trong khi SFT chỉ cần load một model và tính cross-entropy, PPO phải thực hiện forward pass qua cả bốn model chỉ để tính một batch gradient, chưa kể chi phí đồng bộ hóa và lưu trữ trạng thái optimizer. Điều này khiến nhu cầu VRAM tăng lên rất nhiều so với SFT (mức tăng cụ thể phụ thuộc kích thước từng model, optimizer state và việc có offload/shard hay không), biến RLHF thành quy trình chỉ khả thi với các cụm GPU quy mô lớn.
Sự bất ổn định cố hữu
Khác với SFT (hội tụ ổn định và dự đoán được), PPO nổi tiếng khó ổn định. Nhóm tác giả paper “Secrets of RLHF” (Zheng et al., 2023) đã phải dành riêng một công trình để hệ thống hóa hàng loạt “mẹo” thực nghiệm chỉ để giữ cho PPO không sập giữa chừng. Ví dụ: phải chuẩn hóa reward theo thống kê lịch sử, phải clip giá trị của Value function, phải khởi tạo Critic cẩn thận để khớp với Reward Model… Nếu một siêu tham số (learning rate của Actor/Critic, hệ số $\beta$, $\gamma$) lệch dù nhỏ, sự cộng hưởng sai lệch giữa Actor và Critic có thể dẫn đến catastrophic collapse (sụp đổ thảm họa), khiến chất lượng model tụt dốc không phanh và khó khôi phục. PPO tuyệt đối không phải thuật toán “cắm là chạy”.
Reward Hacking: không chỉ là rủi ro lý thuyết
Đây là điểm yếu chí mạng nhất. Vì reward model chỉ là hàm xấp xỉ nên chắc chắn có điểm mù, và policy (một tác nhân tối ưu hóa cực mạnh) sẽ nhanh chóng tìm ra và khai thác chúng.
Một hiện tượng đã được ghi nhận rõ trong thực nghiệm là Length Bias (thiên vị độ dài). Singhal et al. (2023) chỉ ra rằng trong nhiều pipeline RLHF mã nguồn mở, phần lớn cải thiện điểm số sau huấn luyện thực chất đến từ việc model học cách trả lời dài hơn, chứ không phải trả lời tốt hơn về nội dung. Reward model thường có xu hướng ngầm chấm điểm cao cho những câu trả lời dài, chi tiết, có cấu trúc rõ ràng, ngay cả khi phần nội dung mở rộng đó vô nghĩa hoặc lặp lại.
Cú “đấm” thực nghiệm: nhóm Singhal thậm chí chứng minh rằng nếu huấn luyện một model với phần thưởng chỉ dựa trên độ dài câu trả lời (bỏ qua hoàn toàn nội dung), model đó vẫn tái tạo được phần lớn mức cải thiện điểm số mà một pipeline RLHF thông thường mang lại.
Đây là minh chứng đáng lo ngại: reward model có thể bị “đánh lừa” dễ dàng bởi các đặc điểm bề mặt (surface-level features) thay vì chất lượng thực sự (ground-truth quality).
Nhìn lại: từng chặng học được gì, còn thiếu gì?
| Giai đoạn | Model học gì | Dữ liệu | Giới hạn |
|---|---|---|---|
| Pre-training | Phân phối ngôn ngữ (đoán token tiếp theo) | Văn bản khổng lồ | Giỏi ngôn ngữ nhưng không biết nghe lời |
| SFT | Cách trả lời theo định dạng hỏi–đáp | Cặp (instruction, response) | Point-wise: không phân biệt tốt/tệ, chỉ bắt chước |
| Reward Model | Chấm điểm tương đối (Bradley–Terry) | Preference $(x, y_w, y_l)$ | Thang điểm tương đối, dễ drift, có điểm mù |
| RLHF (PPO) | Tự sinh và tối ưu theo reward | Response do chính policy sinh | Tốn 4 model, bất ổn, reward hacking |
Kết luận
Nếu coi việc xây dựng một trợ lý AI là một cuộc hành trình, thì ta vừa đi qua chặng đầu tiên, và cũng là chặng dài nhất. Bắt đầu với một đứa trẻ chỉ biết lắp ghép từ (pre-training), dạy nó nói theo mẫu (SFT), rồi dạy nó phân biệt hay dở (Reward Model), và cuối cùng cho nó tự rèn luyện qua thử–sai (RLHF/PPO). Mỗi bước là một cuộc cách mạng nhỏ, và khi ghép lại, chúng tạo ra những model có thể trò chuyện, viết code, phân tích, những thứ mà chỉ vài năm trước ta ngỡ là khoa học viễn tưởng.
Nhưng hành trình này cũng lộ ra những vết nứt. Chiếc xe PPO rất mạnh, nhưng tốn xăng, khó lái, và thỉnh thoảng còn bị “lừa” bởi chính chiếc đồng hồ đo tốc độ của mình (reward hacking).
May mắn thay, năm 2023, một nhóm nghiên cứu tại Stanford đã tìm ra một con đường tắt: DPO. Con đường này bỏ qua hoàn toàn chiếc đồng hồ đo (reward model) và vòng lặp phức tạp (PPO), đi thẳng từ preference data đến việc cập nhật model, bằng chính infrastructure của SFT quen thuộc. Chặng tiếp theo sẽ bắt đầu ở bài sau, nơi ta khám phá cách DPO biến một bài toán RL phức tạp thành một bài toán supervised learning đơn giản, và vì sao điều đó thay đổi hoàn toàn cục diện của ngành alignment.
Hẹn gặp lại bạn ở đó.