Nối tiếp bài fine-tuning LLM ở lần trước, giả sử chúng ta có một model 70B đã fine-tune xong, benchmark đẹp, demo trên máy cá nhân mượt. Nhưng khi deploy lên production cho user thật sử dụng — giả sử 5000 người cùng gõ prompt và enter cùng lúc — liệu kết quả có còn đẹp như demo?
Không. Hệ thống sẽ nghẽn, GPU báo Out-of-memory. Vấn đề không nằm ở model, mà ở cách chúng ta serving nó.
Bài này đi từ những khái niệm nền tảng nhất — inference pipeline, prefill/decode, KV Cache, latency, throughput — rồi dần đi sâu vào các kỹ thuật đứng sau những serving engine hiện đại: PagedAttention, prefix caching, continuous batching, chunked prefill, và cuối cùng là cách chọn engine nào cho use case nào.
Serving LLM khác gì serving các model ML truyền thống?
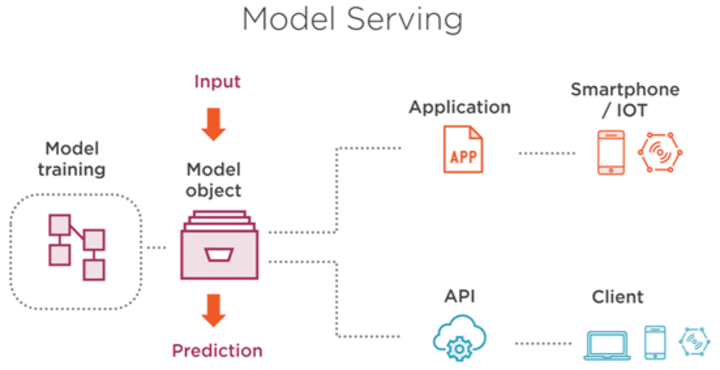
Trong machine learning truyền thống, model serving thường được hình dung khá đơn giản: nhận request, gom thành batch, chạy một forward pass, trả prediction.
Nhưng với LLM thì khác. Nó sinh văn bản theo cơ chế autoregressive: sau khi xử lý prompt, model phải liên tục sinh từng token, trong đó token tiếp theo phụ thuộc vào toàn bộ ngữ cảnh đã sinh trước đó — ví dụ với prompt “Once upon”, model sinh “a”, rồi ghép “Once upon a” làm input cho bước kế tiếp để sinh “time”, cứ thế tiếp tục.
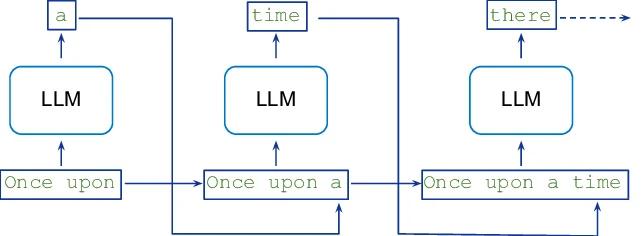
Một request vì thế không còn là một phép inference duy nhất, mà trở thành một chuỗi các bước inference có trạng thái và thời gian sống khác nhau.
Điều này kéo theo hàng loạt bài toán systems mới:
- Làm thế nào để batch các request đang ở những bước decode khác nhau?
- Làm thế nào để scheduler liên tục đưa request mới vào GPU?
- Làm thế nào quản lý KV Cache khi sequence liên tục dài ra?
- Làm thế nào tối ưu đồng thời latency, throughput và chi phí GPU?
- …và hàng chục câu hỏi khác.
Từ giai đoạn LLM deployment bùng nổ, những câu hỏi này dần trở thành một hướng nghiên cứu hệ thống riêng. Một dấu mốc tiêu biểu là PagedAttention/vLLM, công bố tại SOSP 2023. Paper này nhìn LLM serving từ góc độ quản lý bộ nhớ: KV Cache có kích thước lớn, thay đổi động, dễ gây fragmentation — nên tác giả mượn ý tưởng paging của hệ điều hành để quản lý nó hiệu quả hơn.
Gộp lại, LLM serving không đơn giản là “chạy LLM nhanh hơn”. Đó là bài toán phối hợp giữa model architecture, inference algorithm, scheduling, memory management, GPU runtime và distributed systems.
Inference vs Training
Training là quá trình điều chỉnh trọng số (weights) của model để nó học pattern từ dữ liệu — forward pass, tính loss, backward pass, cập nhật weights, lặp lại hàng triệu lần. Việc này thường làm một lần (hoặc định kỳ), offline. Có thể mất nhiều giờ, nhiều ngày, thậm chí nhiều tuần để train một model mà không có người dùng nào phải ngồi chờ kết quả từng bước. Mục tiêu chính là:
Làm sao hoàn thành training với lượng compute và thời gian hợp lý để model đạt chất lượng mong muốn?
Inference thì ngược lại — dùng bộ trọng số đã cố định để tạo output cho input mới, không có backward pass, không cập nhật weights. Nhưng nó diễn ra liên tục, hàng triệu lần mỗi ngày, và có người dùng thật đang chờ phản hồi ngay trên màn hình:
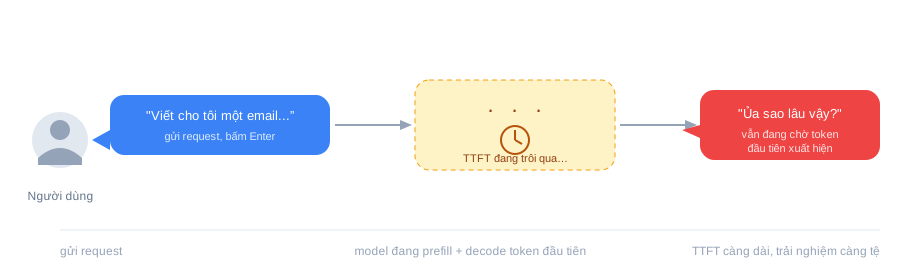
Vì thế, nếu training quan tâm nhiều đến $\text{FLOPs}$ (Floating Point Operations Per Second) và thời gian hội tụ, serving phải quan tâm thêm đến latency, throughput, memory, concurrency, GPU utilization và cost/request.
Một cách hình dung đơn giản: training giống như xây dựng một nhà máy, serving giống như vận hành nhà máy đó mỗi ngày. Xây nhà máy chậm một chút có thể chấp nhận được. Nhưng khi nhà máy đã chạy production, mỗi phút downtime hoặc mỗi đơn hàng xử lý chậm đều có thể trở thành tiền.
LLM Serving khác gì API Backend thông thường?
Một backend API thông thường (ví dụ API tra cứu đơn hàng): nhận request → query database hoặc tính toán đơn giản → trả response trong vài chục mili-giây. Chi phí xử lý gần như không đổi giữa các request, và server không cần “nhớ” gì giữa các bước xử lý của cùng một request.
Với LLM serving, có ít nhất 3 điểm khác biệt:
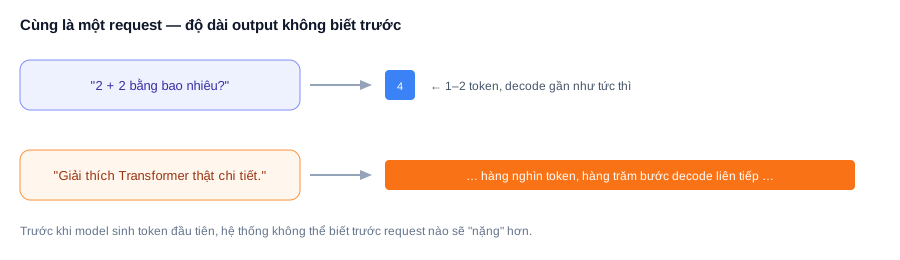
Output sinh ra từng token một. Một request có thể mất từ vài trăm mili-giây đến hàng chục giây, tùy độ dài output — và hiện chưa có phương pháp nào biết trước chính xác độ dài đó.
Mỗi request cần một vùng nhớ trạng thái riêng gọi là KV Cache (lưu lại “ngữ cảnh” model đã xử lý), và vùng nhớ này lớn và thay đổi kích thước liên tục trong lúc xử lý. Theo nhóm phát triển vLLM, nếu quản lý không hiệu quả, KV Cache sẽ bị lãng phí nghiêm trọng do phân mảnh (fragmentation) và trùng lặp dữ liệu — điều này trực tiếp giới hạn số request có thể xử lý đồng thời trên một GPU (Kwon et al., SOSP 2023).
Chi phí tính toán trên mỗi request không cố định — request sinh 20 token rẻ hơn nhiều so với request sinh 2000 token, và ta chỉ biết chi phí thật sau khi model dừng sinh kết quả.
Đây là lý do một backend viết bằng Flask/FastAPI đơn giản không đủ để serving LLM ở quy mô production — cần một engine chuyên biệt (vLLM, TensorRT-LLM, SGLang…) quản lý bộ nhớ và lịch trình xử lý.
Một request LLM thực sự chạy như thế nào?
Một pipeline đơn giản có thể hình dung như sau:
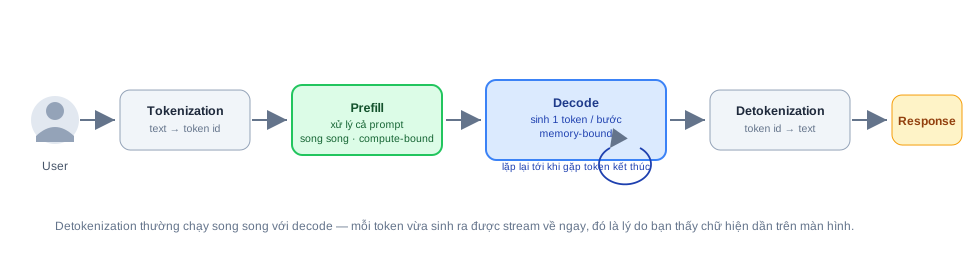
Trong đó Prefill và Decode là hai phần quan trọng nhất.
Tokenization
LLM không trực tiếp làm việc với string, mà được tokenizer chuyển thành một chuỗi token ID. Ví dụ “The dog sat on the couch” được chuyển thành [4, 22, 63, 7, 4, 143].
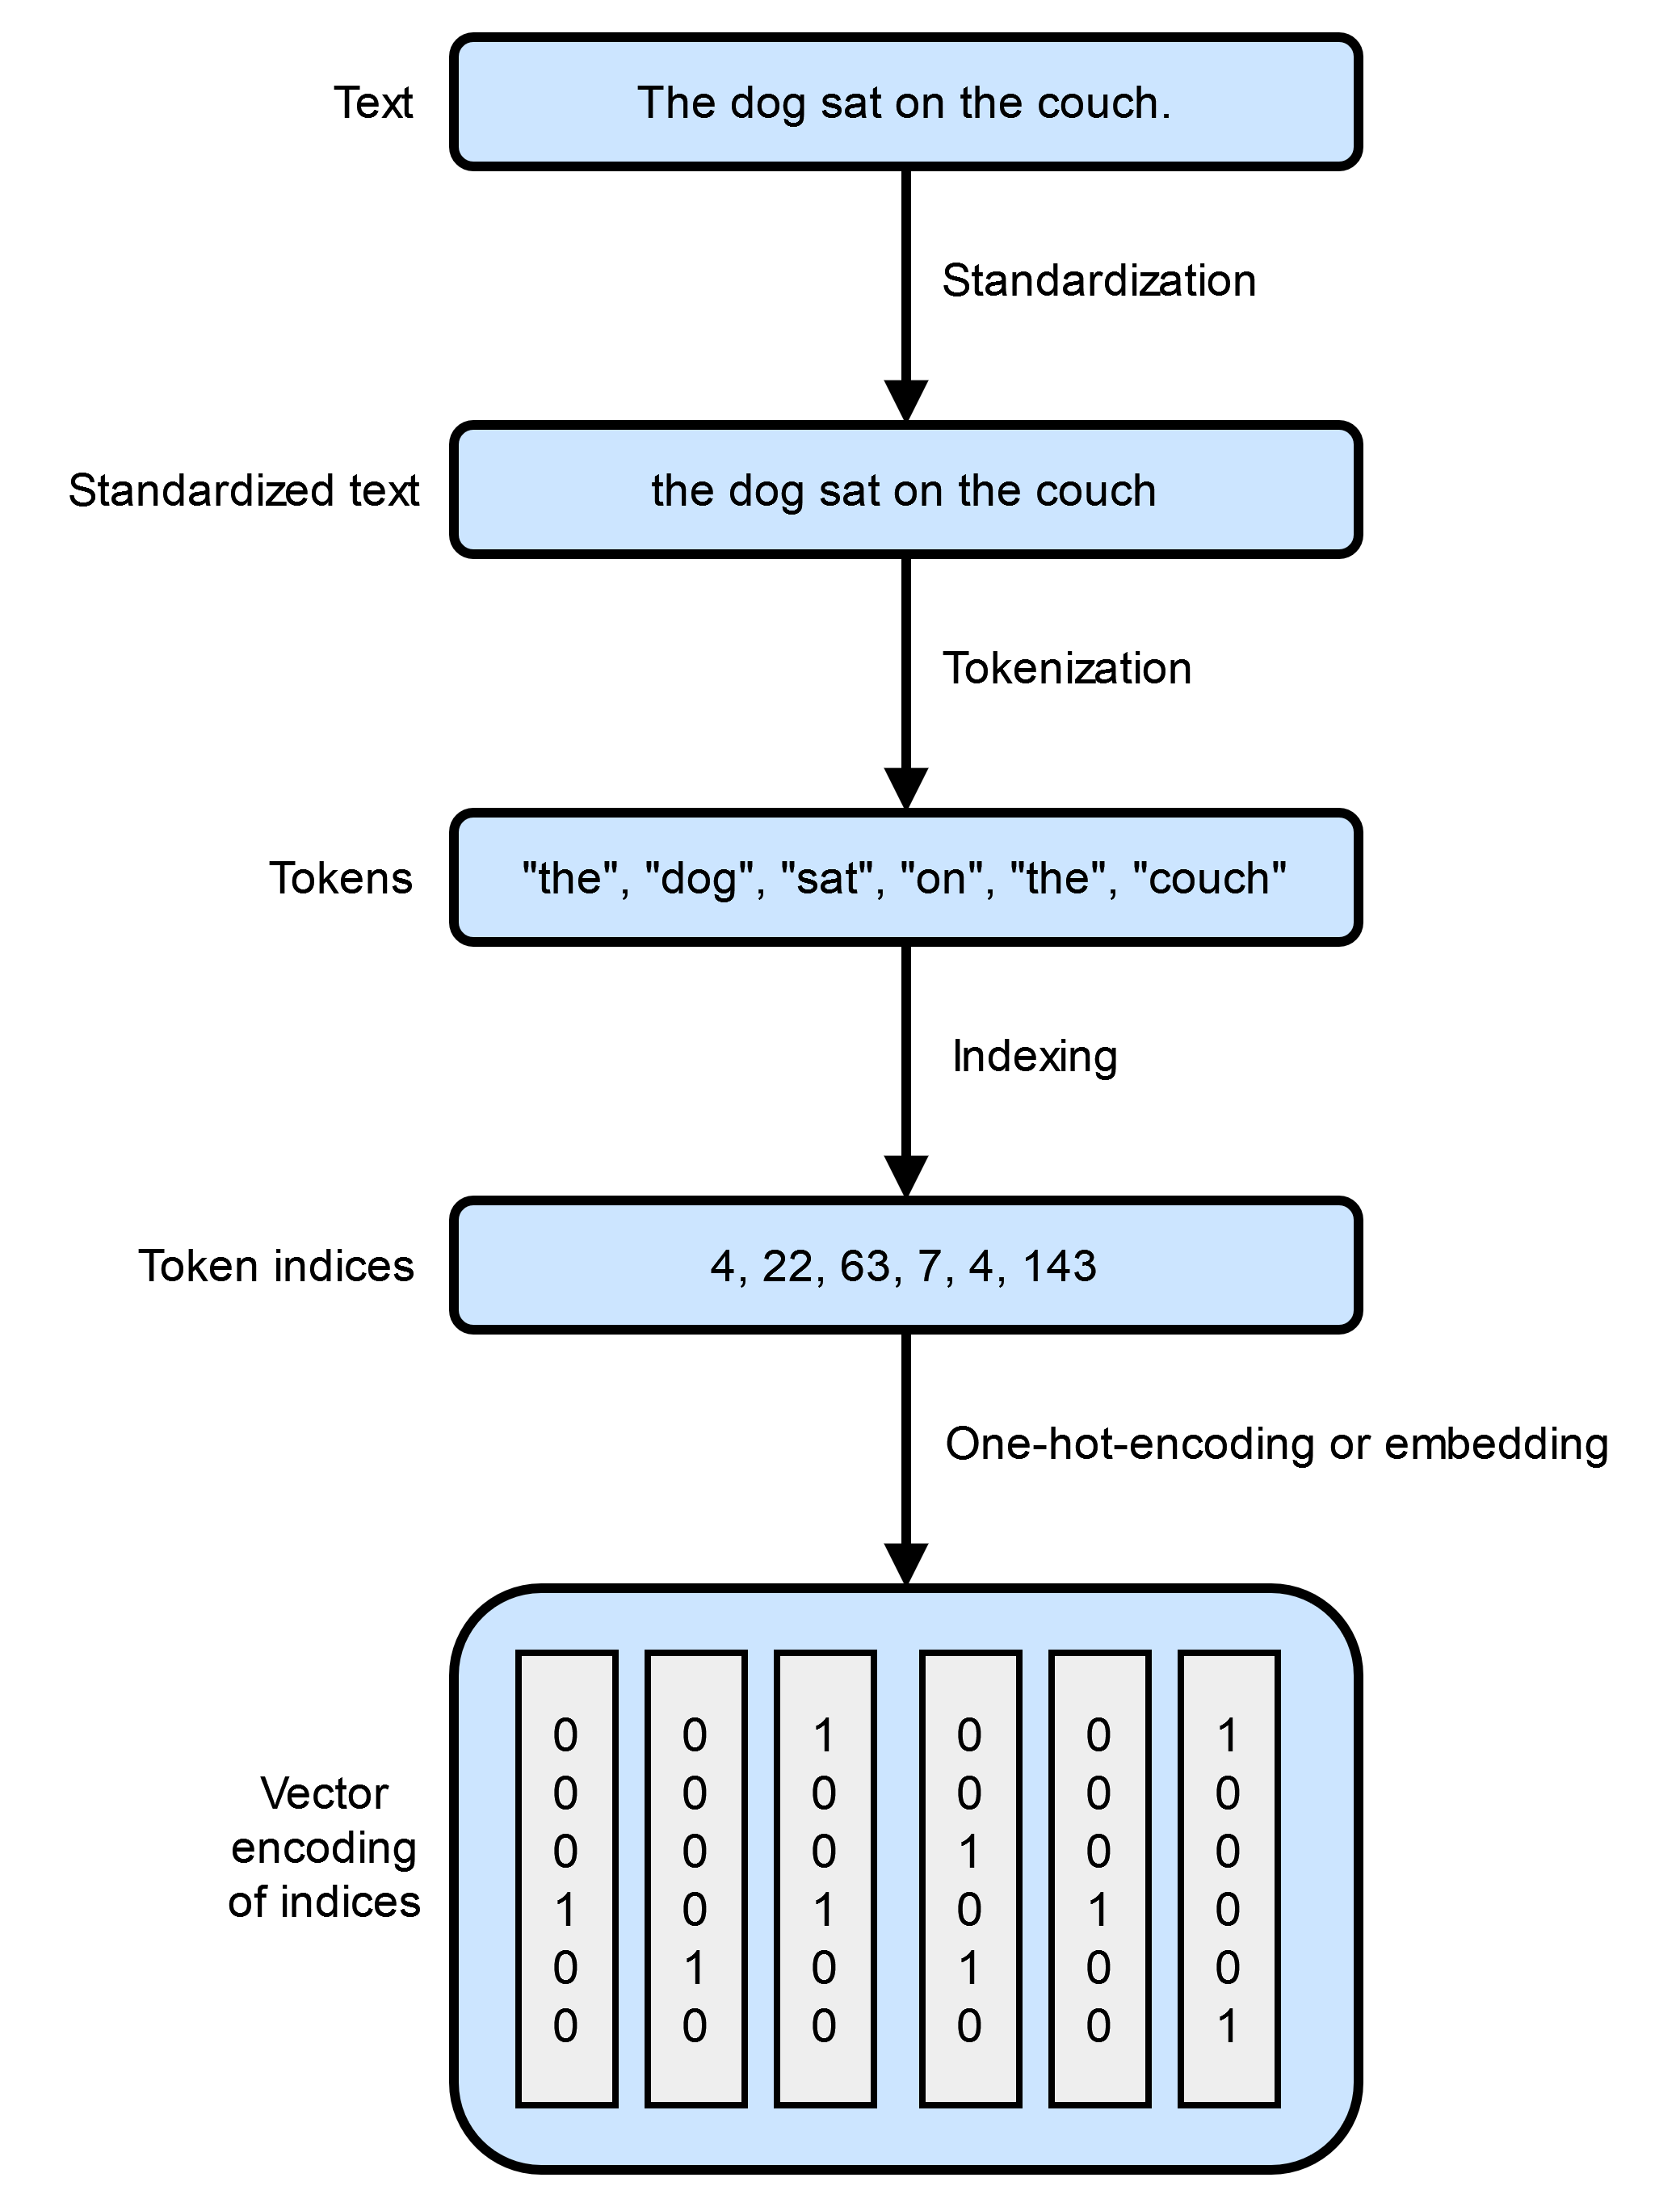
Token không nhất thiết tương ứng đúng với một từ — một từ có thể là một token, nhiều token, hoặc chỉ một phần của token. Từ “unhappiness” có thể chia thành “un” + “happi” + “ness”. Cách tokenizer chia văn bản ảnh hưởng trực tiếp đến số lượng token, context length, thời gian inference và chi phí API — đây cũng là lý do cùng một câu nhưng dùng tokenizer khác nhau có thể ra số token khác nhau đáng kể.
Prefill
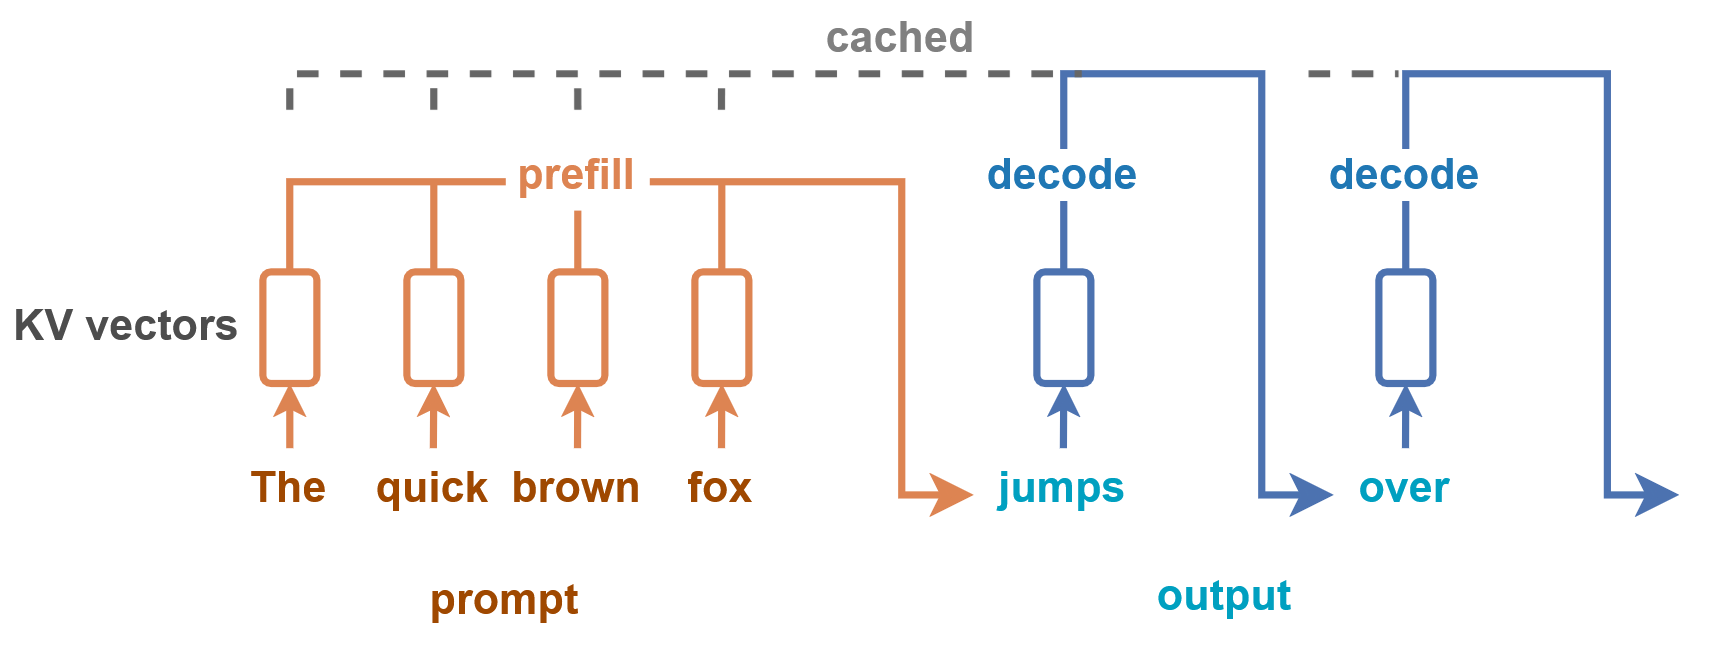
Sau khi tokenization xong, toàn bộ token của prompt đầu vào được đưa qua model cùng một lúc, song song, để tính ra biểu diễn Key-Value (KV) cho từng token trong prompt. Bước này nặng về tính toán vì phải nhân ma trận với toàn bộ prompt, và nó quyết định thời gian phải chờ trước khi thấy chữ đầu tiên xuất hiện trên màn hình.
Decode
Sau prefill, model bắt đầu sinh câu trả lời — nhưng theo kiểu autoregressive: lần lượt, từng token một, mỗi token mới được sinh dựa trên toàn bộ token trước đó (prompt + các token đã sinh), thông qua KV Cache đã lưu từ bước prefill.
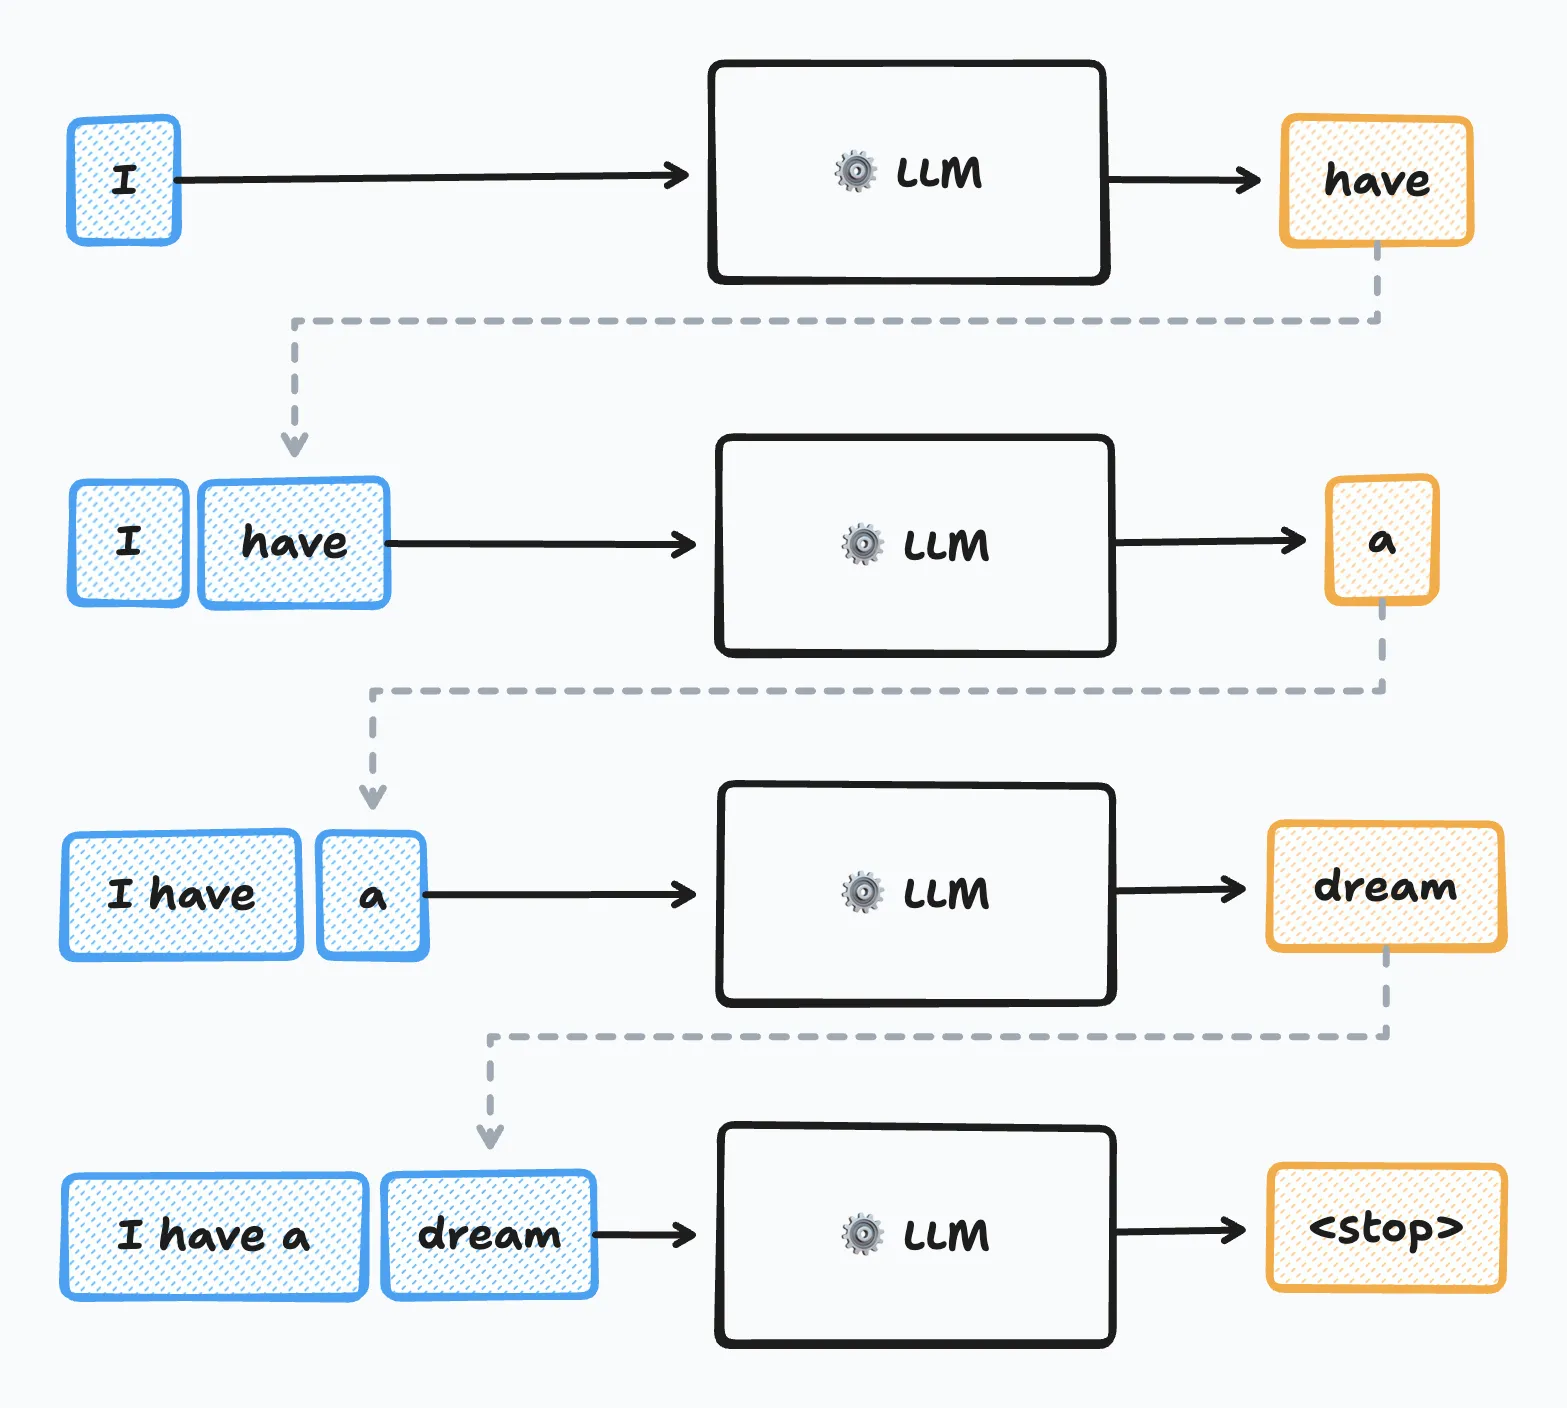
Ví dụ nhập prompt “Thủ đô Việt Nam là”, model sinh: Token 1 → “Hà”, Token 2 → “Nội”, Token 3 → “.”.
Khác với prefill, bước decode nặng về đọc bộ nhớ hơn là tính toán — vì với mỗi token mới, GPU phải đọc lại toàn bộ trọng số model và KV Cache từ bộ nhớ, trong khi lượng phép tính thực tế cho một token lại nhỏ (Zhong et al., DistServe, OSDI 2024). Đây là lý do prefill và decode có đặc tính rất khác nhau, và một số hệ thống serving hiện đại (như DistServe) tách hẳn hai giai đoạn này ra chạy trên GPU riêng để tránh chúng cản trở nhau.
Detokenization
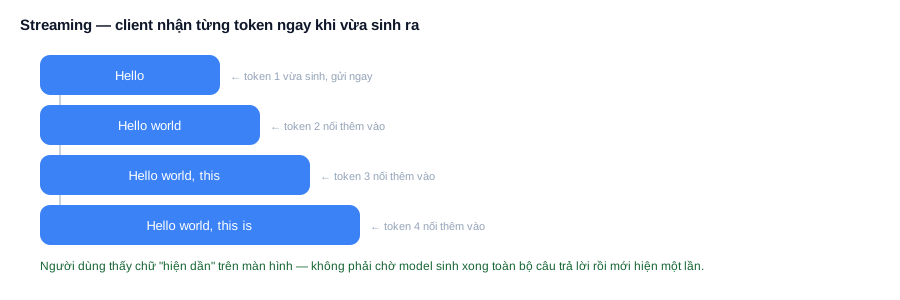
Sau khi model sinh token ID (ví dụ [15496, 995, ...]), server phải chuyển chúng trở lại thành text ("Hello world..."). Với API streaming, server gửi token về client ngay khi chúng được sinh, nên người dùng thấy chữ hiện dần thay vì phải chờ model sinh xong toàn bộ câu trả lời.
Đo hiệu suất serving: latency và throughput
Muốn biết cách serving hiện tại có hiệu quả hay không, cần trả lời hai câu hỏi: một user phải chờ bao lâu (latency), và một server phục vụ được bao nhiêu user (throughput).
TTFT — Time To First Token
TTFT là thời gian từ khi request được gửi đến khi token đầu tiên xuất hiện.
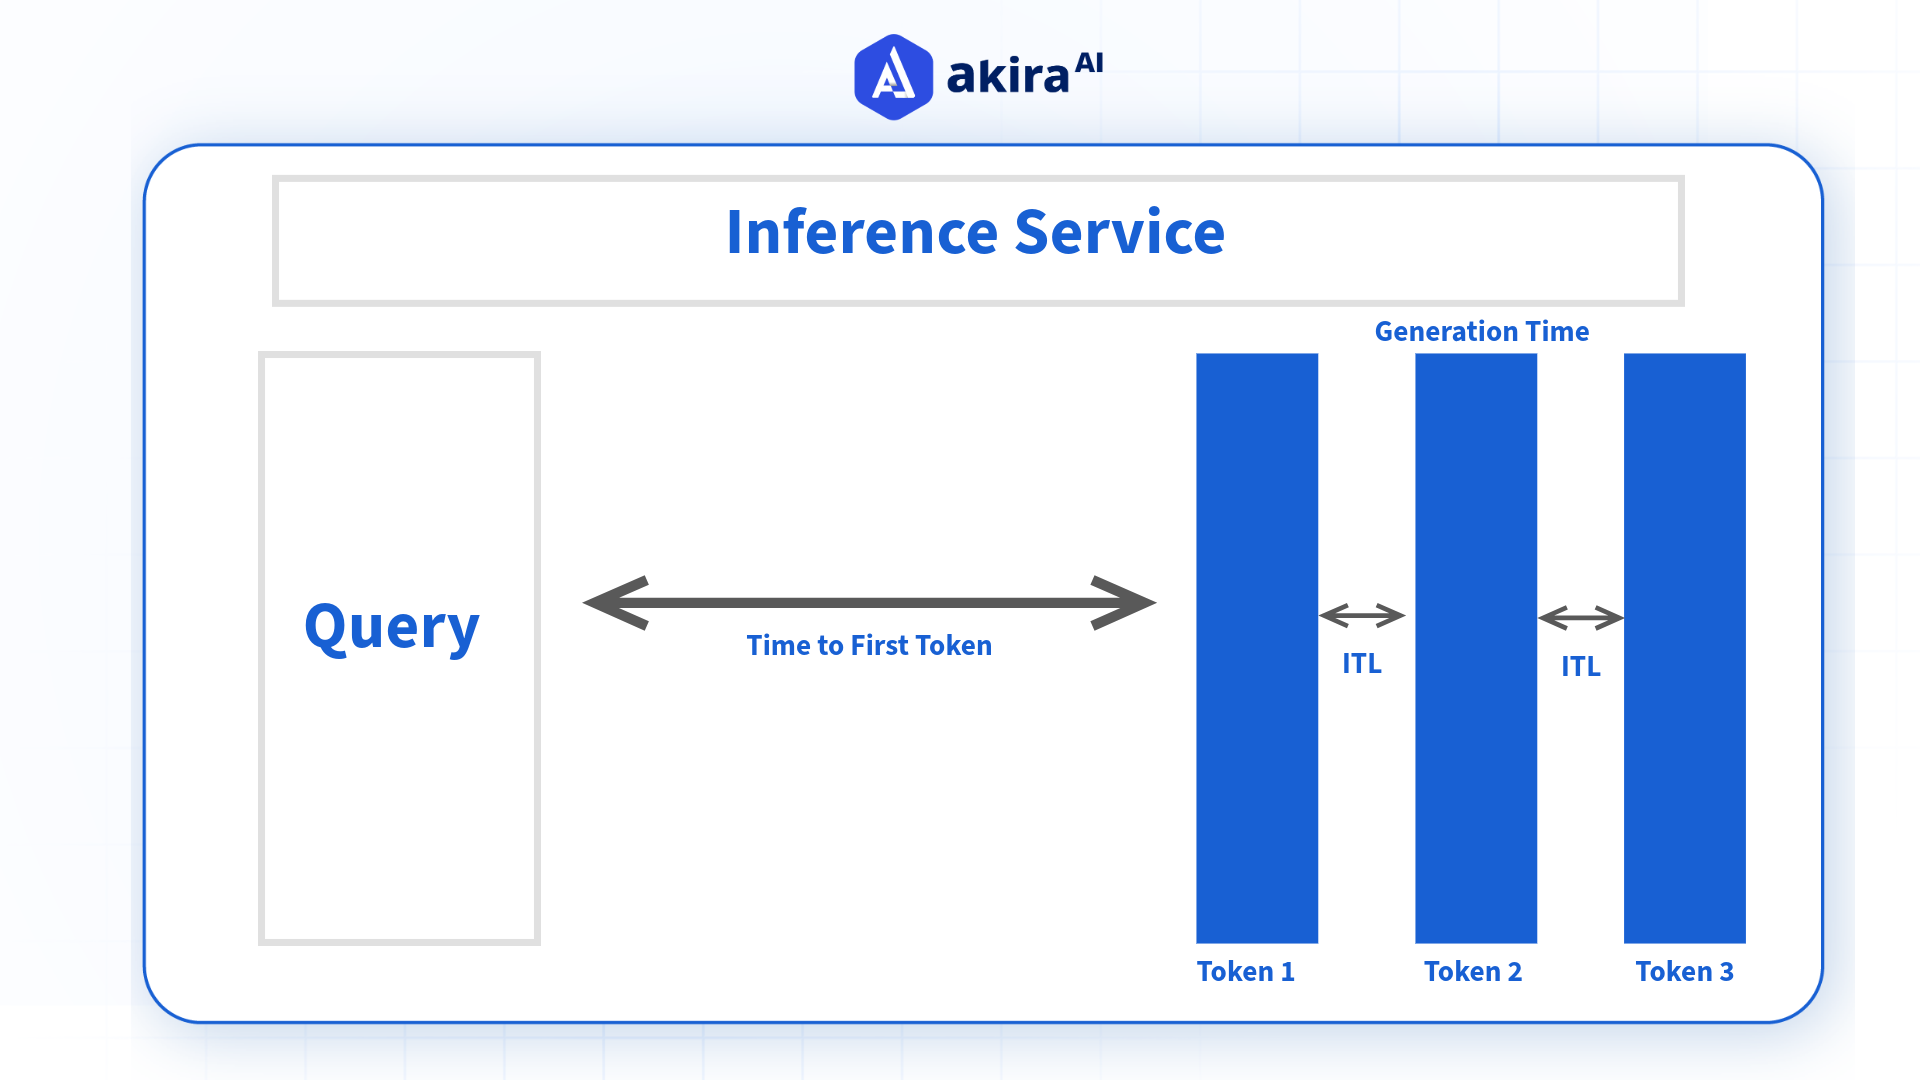
Nếu ChatGPT mất 3 giây mới bắt đầu hiện chữ, cảm giác của người dùng sẽ rất khác so với việc chữ xuất hiện sau 300ms — dù tổng thời gian sinh câu trả lời cuối cùng có thể giống nhau.
TPOT — Time Per Output Token
Sau token đầu tiên, ta quan tâm tốc độ sinh các token tiếp theo.
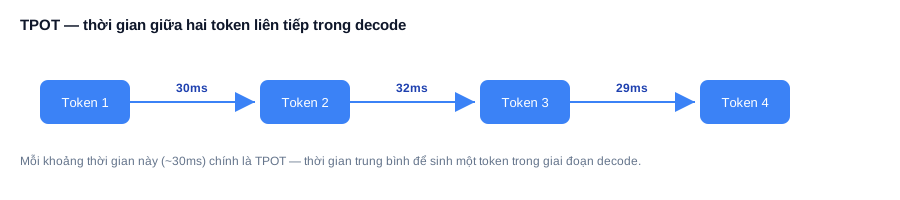
TPOT là thời gian trung bình giữa các token output — càng thấp thì streaming càng mượt.
Total Latency và Throughput
Một cách đơn giản để hình dung tổng latency:
$$\text{Total Latency} \approx \text{TTFT} + \text{Decode Time}$$Nếu có 100 output token và tốc độ decode trung bình khoảng 30ms/token:
$$\text{TTFT} = 500\text{ms}, \quad \text{Decode} \approx 100 \times 30\text{ms} = 3000\text{ms}$$$$\text{Total} \approx 3.5\text{s}$$Đây là mô hình hóa đơn giản; benchmark thực tế còn có queueing, scheduling và các overhead khác.
Nếu latency trả lời “một request mất bao lâu?”, thì throughput trả lời “cả hệ thống sinh được bao nhiêu token trong một khoảng thời gian?”. Ví dụ 3 user sinh lần lượt 100, 200, 300 token trong một giây:
$$\text{Throughput} = 600 \text{ tokens/s}$$Đây là throughput của cả hệ thống, không có nghĩa một user đang nhìn thấy 600 tokens/s — một hệ thống có thể đạt 1000 tokens/s nhờ phục vụ 100 request đồng thời, trong khi một request riêng lẻ chỉ nhận khoảng 10 tokens/s. Đây là điểm rất dễ hiểu nhầm khi đọc benchmark: đừng chỉ nhìn một con số TPS, hãy hỏi thêm — throughput tính theo cái gì, bao nhiêu concurrent request, input/output length bao nhiêu, TTFT/TPOT bao nhiêu, chạy trên hardware nào.
Và nếu phải chọn một thứ để đào sâu tiếp theo, đó sẽ là KV Cache — vì muốn hiểu PagedAttention, continuous batching, prefix caching, hay tại sao LLM serving lại ngốn VRAM khủng khiếp, gần như đều phải bắt đầu từ đây.
KV Cache: trung tâm của mọi tối ưu
Nhắc lại nhanh: với mỗi token, ở mỗi layer và mỗi attention head, model tính ra một cặp vector Key (K) và Value (V). KV Cache lưu lại toàn bộ các cặp K/V này để những bước decode sau không phải tính lại từ đầu. Nó tăng dần theo số token đã xử lý (prompt + output đã sinh), và độ dài cuối cùng không biết trước — đây là nguồn gốc của mọi vấn đề tối ưu bên dưới.
Paged KV Cache
Cách “ngây thơ” để lưu KV Cache là cấp cho mỗi request một vùng nhớ liên tục (contiguous) đủ lớn cho độ dài tối đa model hỗ trợ — giống việc đặt trước cả rạp chỉ vì không biết khách sẽ ở lại bao lâu. Vấn đề: đa số request không dùng hết vùng đã cấp, gây lãng phí (internal fragmentation); các request có độ dài khác nhau còn để lại những khoảng trống không đủ lớn để tái sử dụng (external fragmentation) — nhóm vLLM đo được rằng cách làm này khiến các hệ thống trước đó chỉ dùng hiệu quả 20,4%–38,2% bộ nhớ đã cấp phát (Kwon et al., SOSP 2023).
Paged KV Cache mượn nguyên ý tưởng phân trang bộ nhớ ảo (virtual memory paging) từ hệ điều hành: chia KV Cache thành các block kích thước cố định (ví dụ 16 token/block), không cần nằm liên tục trong bộ nhớ vật lý. Mỗi request có một block table — bảng ánh xạ từ vị trí logic của token sang địa chỉ vật lý (block nào, ở đâu trong GPU memory) — tương tự page table trong hệ điều hành. Nhờ vậy, hệ thống chỉ cấp phát thêm block mới khi request thực sự cần, và có thể lấp các block trống bằng request khác — gần như xoá sạch tình trạng lãng phí nêu trên.
PagedAttention
Chia KV Cache thành các block rời rạc kéo theo một vấn đề kỹ thuật: phép tính attention (nhân Query với toàn bộ Key/Value đã lưu) thường giả định dữ liệu nằm liên tục trong bộ nhớ để tính hiệu quả. PagedAttention là thuật toán attention được viết lại để đọc và tính toán trực tiếp trên các block rời rạc đó, tra theo block table, mà không cần “dồn” (gather) chúng về một vùng liên tục trước khi tính — tránh chi phí sao chép dữ liệu không cần thiết (Kwon et al., SOSP 2023).
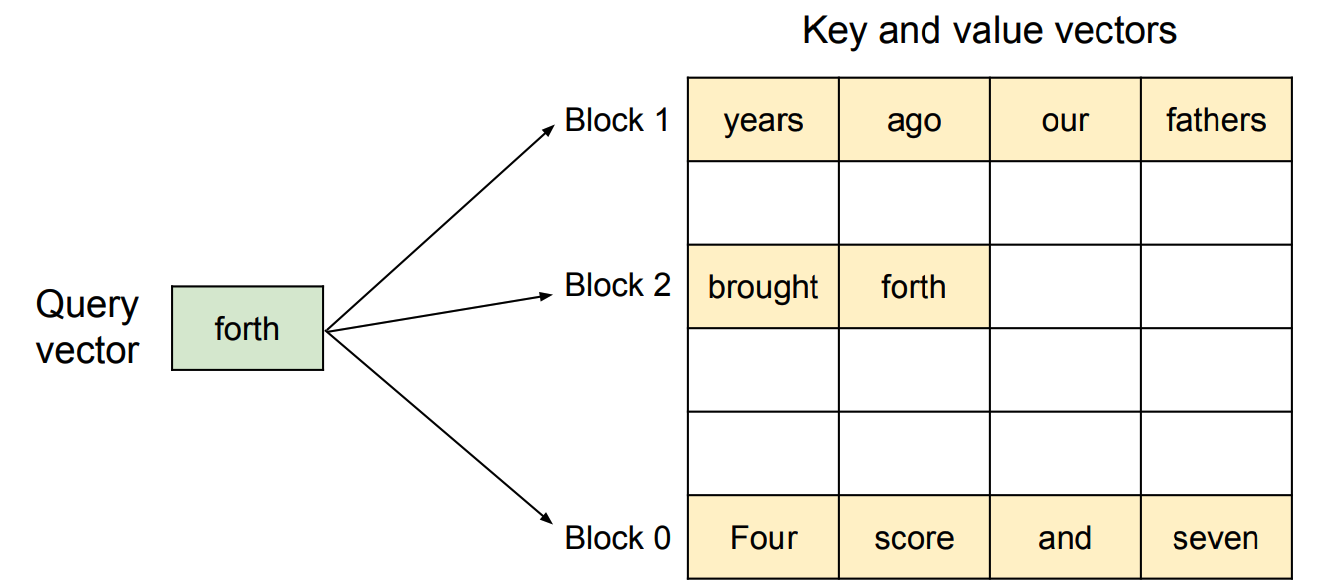
Một lợi ích đi kèm đáng chú ý: vì các block được quản lý như những đơn vị độc lập có thể tham chiếu từ nhiều nơi (giống cơ chế copy-on-write trong hệ điều hành), nhiều chuỗi có thể chia sẻ chung các block KV Cache khi chúng có phần đầu giống nhau — ví dụ trong parallel sampling (sinh nhiều output khác nhau từ cùng một prompt) hay beam search. Thay vì mỗi output phải lưu một bản KV Cache riêng cho đoạn prompt chung, chúng có thể tham chiếu tới cùng các block đó, chỉ tách ra (copy) khi nội dung thực sự khác nhau. Đây chính là ý tưởng nền cho prefix caching.
Prefix caching
PagedAttention giải quyết bài toán chia sẻ KV Cache trong một request (nhiều output cùng prompt). Nhưng có một cơ hội lớn hơn: rất nhiều request khác nhau lại có phần đầu (prefix) giống hệt nhau — cùng một system prompt, cùng vài ví dụ few-shot, hoặc cùng lịch sử hội thoại trong một cuộc chat nhiều lượt.
Prefix caching là kỹ thuật phát hiện và tái sử dụng KV Cache cho phần prefix trùng nhau giữa các request, tránh phải tính lại prefill cho phần đó. vLLM có tính năng “automatic prefix caching” dựa trên PagedAttention. Đi xa hơn, SGLang giới thiệu RadixAttention (Zheng et al., NeurIPS 2024, arXiv:2312.07104) — quản lý toàn bộ KV Cache đã từng tính trong một cấu trúc cây gọi là radix tree, cho phép server tự động tìm phần prefix dài nhất đã có sẵn trong cache cho bất kỳ request mới tới, không chỉ giới hạn trong một request hay một phiên hội thoại đơn lẻ — kể cả với workload phức tạp hơn hội thoại tuyến tính, như agent phân nhánh nhiều hướng suy luận từ cùng một điểm xuất phát.
Lợi ích thực tế lớn nhất rơi vào các workload có tỷ lệ trùng prefix cao: chatbot dùng chung system prompt dài, ứng dụng agent gọi nhiều lượt với phần ngữ cảnh chung, hay RAG với cùng một số đoạn tài liệu được nhồi lại nhiều lần. Với các workload đó, prefix caching có thể cắt giảm đáng kể cả TTFT và tổng lượng tính toán tiêu thụ.
KV Cache quantization
Một hướng khác, độc lập với hai hướng trên: giảm số byte cần dùng cho mỗi giá trị trong KV Cache, tức lượng tử hóa (quantization) nó — ví dụ từ FP16 (16-bit) xuống 4-bit hay 2-bit.
Nhóm nghiên cứu KIVI (Liu et al., ICML 2024, arXiv:2402.02750) khảo sát phân phối giá trị thực tế trong KV Cache của các LLM phổ biến, và phát hiện Key và Value có đặc tính khác nhau: Key nên được lượng tử hóa theo chiều channel (nhóm các phần tử theo channel rồi lượng tử hóa cùng nhau), còn Value nên lượng tử hóa theo chiều token. Dựa trên phát hiện này, họ đề xuất KIVI — thuật toán lượng tử hóa 2-bit không cần tinh chỉnh (tuning-free) cho KV Cache. Trên các model Llama-2, Falcon và Mistral, KIVI giữ được chất lượng gần tương đương bản gốc trong khi giảm 2.6 lần bộ nhớ đỉnh, cho phép tăng batch size tối đa lên 4 lần, và đạt throughput cao hơn 2.35–3.47 lần trên workload inference thực tế (Liu et al., ICML 2024).
Đây là một hướng nghiên cứu đang phát triển rất nhanh (nhiều biến thể mới như KVQuant, RotateKV, AsymKV liên tục xuất hiện sau KIVI) — cho thấy vẫn là bài toán mở, chưa có giải pháp “đóng băng” nào được toàn ngành đồng thuận.
Khi nào KV Cache trở thành bottleneck?
Gộp lại các phần trên, KV Cache có xu hướng trở thành nút thắt cổ chai rõ rệt nhất khi:
- Context dài. Kích thước KV Cache tăng tuyến tính theo số token đã xử lý, nên các ứng dụng dùng context window lớn (tài liệu dài, lịch sử hội thoại dài, RAG nhồi nhiều đoạn) sẽ nhanh chóng chiếm hết bộ nhớ khả dụng, dù model vẫn còn “chỗ” về mặt tham số.
- Concurrency cao. Nhiều request chạy đồng thời nghĩa là nhiều KV Cache riêng biệt cùng tồn tại — dung lượng KV Cache khả dụng chính là thứ đặt giới hạn trên cho batch size, chứ không phải sức mạnh tính toán của GPU.
- Ít trùng lặp prefix. Nếu mọi request đều hoàn toàn khác nhau (không có system prompt chung, không phải hội thoại nhiều lượt), prefix caching gần như không giúp được gì — bottleneck quay lại thuần về dung lượng và băng thông bộ nhớ.
- Quản lý bộ nhớ kém. Ngay cả khi tổng dung lượng GPU đủ lớn, cách cấp phát ngây thơ (không paging) vẫn có thể khiến hệ thống “cạn bộ nhớ” sớm hơn nhiều so với lý thuyết.
Ba kỹ thuật ở trên không loại trừ nhau — một hệ thống production hiện đại thường kết hợp cả ba: paging để tránh lãng phí bộ nhớ, prefix caching để tránh tính lại phần trùng, và quantization để giảm dung lượng mỗi giá trị lưu trữ — cộng với các kỹ thuật giảm kích thước KV Cache ngay từ kiến trúc model (như GQA/MQA).
Nhưng có đủ bộ nhớ không có nghĩa là bạn đang dùng nó tốt. Ngay cả khi KV Cache dư dả, một cách lên lịch (schedule) tồi vẫn có thể khiến GPU ngồi không phần lớn thời gian trong khi request vẫn xếp hàng dài. Phần tiếp theo đi sâu vào cơ chế giải quyết đúng vấn đề đó — cơ chế đứng sau gần như mọi engine serving LLM hiện đại.
Batching và Scheduling
Vì sao batching truyền thống không hoạt động tốt với LLM?
Batching kiểu truyền thống — gom một nhóm request cố định, xử lý tới khi tất cả xong mới trả kết quả — gọi là static batching. Với các model có output cố định độ dài (ảnh, phân loại), cách này ổn vì mọi request trong batch tốn thời gian gần như nhau. Với LLM thì không: độ dài output của mỗi request khác nhau hoàn toàn, và không ai biết trước con số đó.
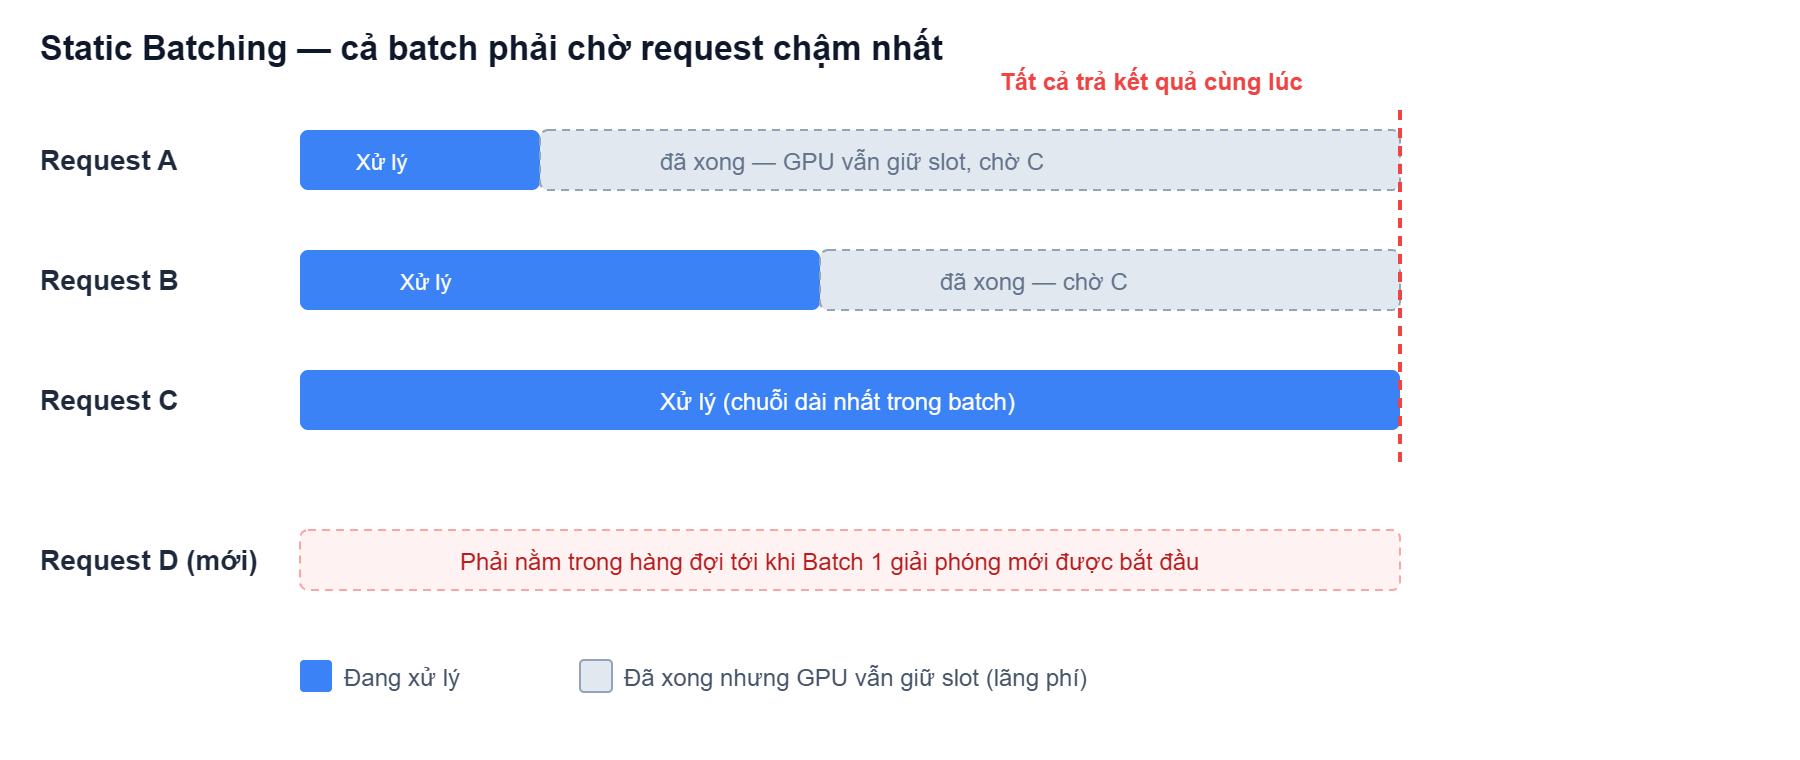
Đây chính là hạn chế mà nhóm Orca chỉ ra ở các hệ thống serving generative model thời điểm 2022: hệ thống dùng lịch trình cứng nhắc không thể thay đổi batch hiện tại, khiến request đã xong sớm không thể trả kết quả ngay, và request mới phải chờ (Yu et al., OSDI 2022).
Continuous Batching
Thay vì lên lịch ở cấp độ request (đưa cả batch vào, đợi cả batch ra), continuous batching lên lịch lại ở cấp độ iteration — mỗi bước sinh một token. Ở mỗi iteration, scheduler được gọi lại và có toàn quyền định nghĩa batch mới: ai rời đi, ai được thêm vào.
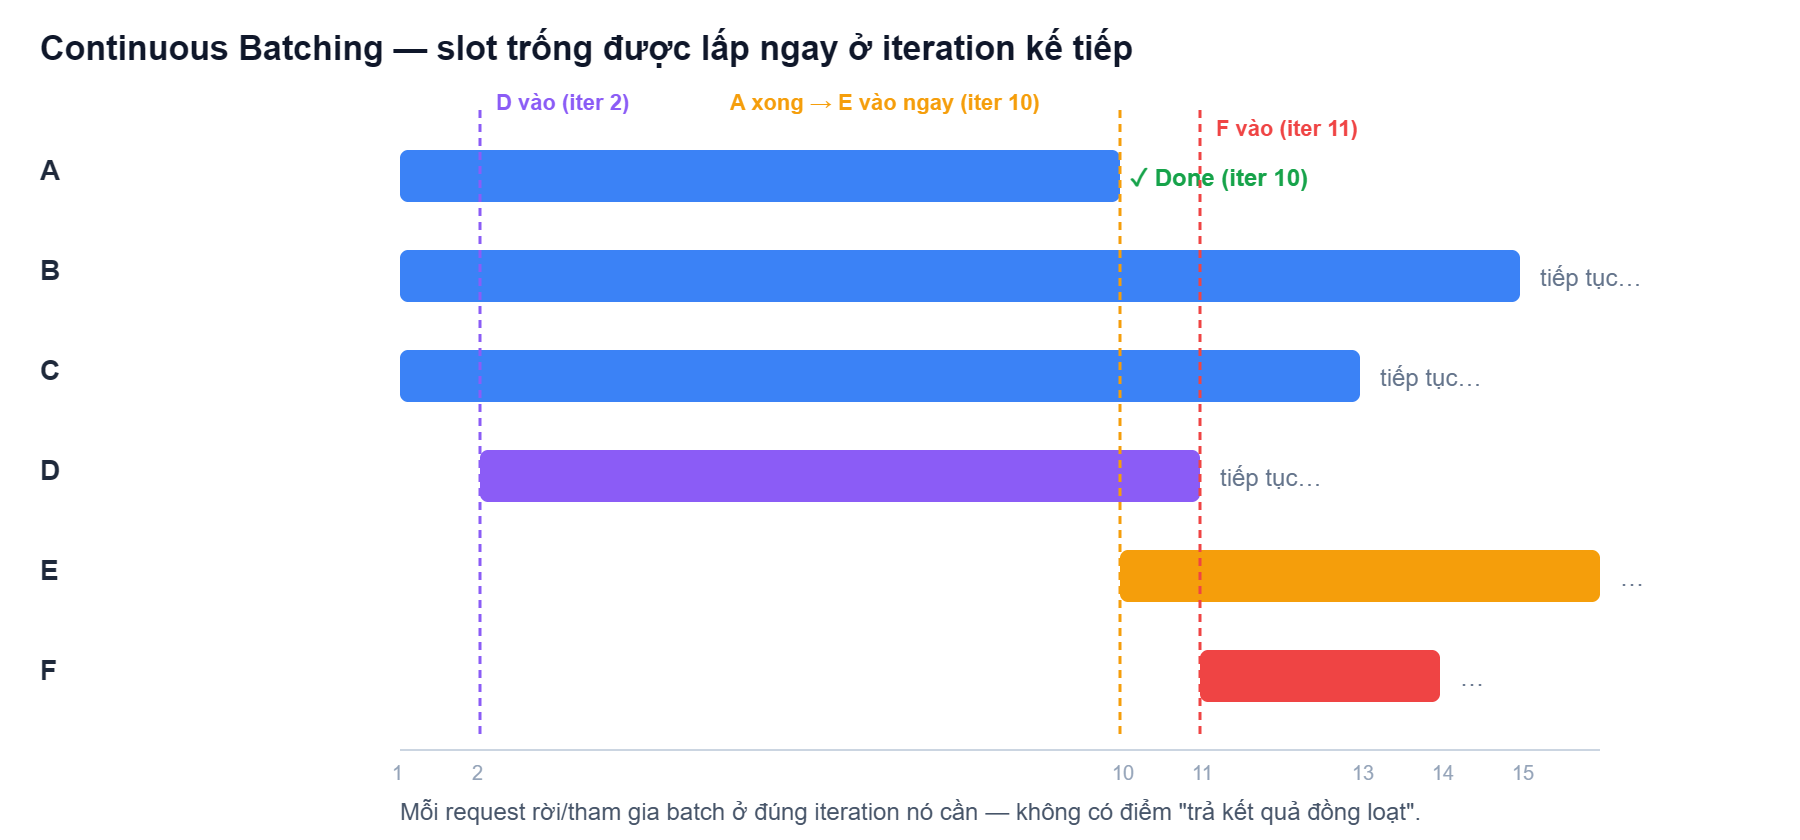
Đọc timeline trên theo đúng cách nó vận hành: batch bắt đầu với A, B, C; request D mới tới được thêm thẳng vào ngay khi có chỗ trống, không cần đợi ai xong. Khi A hoàn tất, nó rời batch ngay lập tức — client nhận kết quả tức thì, không phải chờ B hay C — và request E đang xếp hàng được đưa vào, lấp ngay vào khoảng trống GPU vừa giải phóng. Không có một “điểm trả kết quả đồng loạt” nào cả — mỗi request có vòng đời độc lập trên cùng một GPU đang chạy liên tục.
Về mặt thuật ngữ, ba cách gọi sau mô tả cùng một cơ chế, chỉ khác góc nhìn: request-level scheduling là cách cũ (đơn vị lên lịch là request), iteration-level scheduling là thuật ngữ Orca dùng để mô tả cơ chế bên dưới (đơn vị lên lịch là một bước sinh token), còn continuous batching là tên ngành công nghiệp dùng để mô tả kết quả quan sát được từ bên ngoài.
Kết quả đo được trong paper gốc, kết hợp thêm kỹ thuật selective batching (chỉ áp dụng batching cho các phép toán phù hợp như nhân ma trận tuyến tính, còn attention xử lý riêng từng chuỗi vì độ dài khác nhau): throughput cao hơn NVIDIA FasterTransformer tới 36.9 lần ở cùng mức độ trễ, khi phục vụ GPT-3 175B (Yu et al., OSDI 2022).
Chunked Prefill
Continuous batching giải quyết “ai được ở trong batch”. Nhưng nó mở ra một vấn đề mới: trong cùng một iteration, batch có thể chứa cả request đang decode lẫn request cần prefill cùng lúc — ví dụ ba request A, B, D đang decode (mỗi bước chỉ cần sinh một token), trong khi request C vừa tới, cần prefill toàn bộ prompt trước khi có thể bắt đầu decode.
Vấn đề: hai loại công việc này có đặc tính trái ngược nhau — prefill muốn xử lý một lượng lớn token cùng lúc để tận dụng compute, còn decode chỉ sinh vài token mới mỗi bước nhưng cần chạy liên tục, đều đặn để giữ TPOT thấp. Khi hai loại này trộn vào cùng một batch, chúng cạnh tranh trực tiếp tài nguyên GPU trong cùng một iteration — đây chính xác là vấn đề mà nhóm Sarathi-Serve đặt ra làm động lực nghiên cứu: việc trộn các iteration prefill và decode trong cùng một batch khiến việc đạt đồng thời cả throughput cao lẫn latency thấp trở nên khó khăn (Agrawal et al., OSDI 2024).
Giải pháp: đừng để một prompt dài “chiếm trọn” một iteration. Thay vào đó, chia nhỏ phần prefill thành các chunk gần bằng nhau, xử lý xen kẽ với các bước decode đang chạy, thay vì dồn hết vào một lượt.
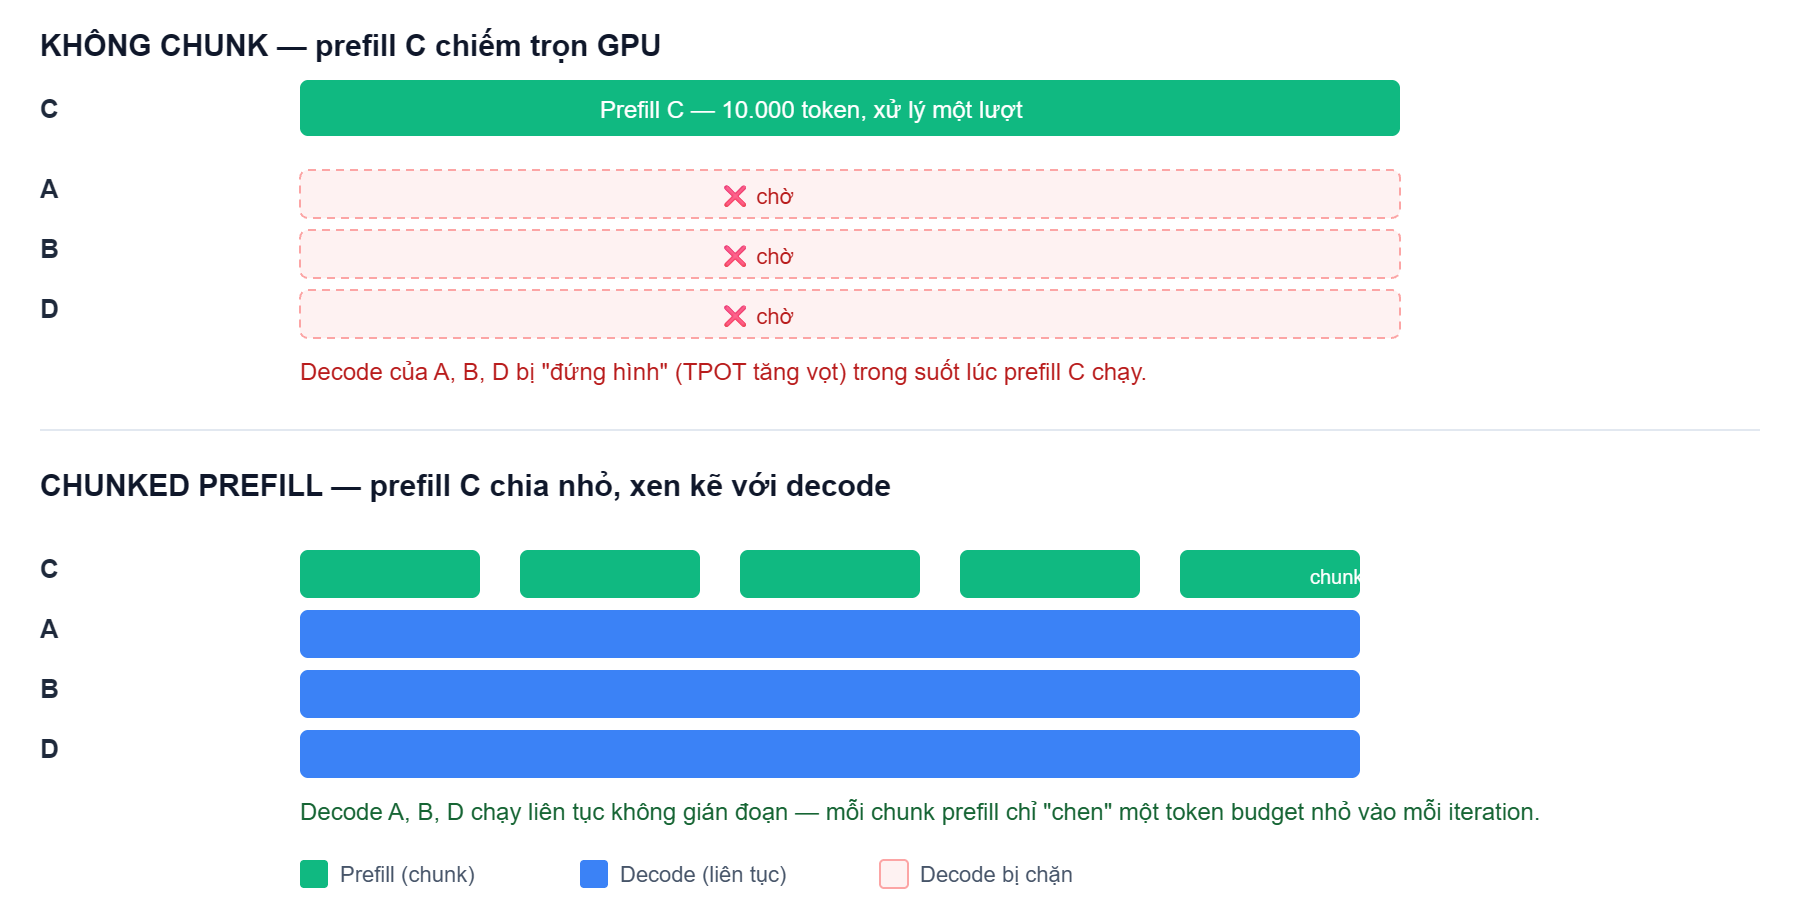
Panel trên minh họa hậu quả của việc không chunk: khi prefill của C (10.000 token) được xử lý trong một lượt duy nhất, các request A, B, D đang decode buộc phải “đứng hình” suốt khoảng thời gian đó — TPOT của chúng tăng vọt, dù bản thân chúng không có vấn đề gì. Panel dưới là cách Sarathi-Serve xử lý: prefill C được chia thành các chunk nhỏ (near-equal size), mỗi iteration chỉ “chen” một chunk vào cùng với các bước decode đang chạy — gọi là stall-free scheduling, vì nó cho phép thêm request mới vào batch mà không làm gián đoạn các decode đang chạy (Agrawal et al., OSDI 2024). Kích thước chunk (chunk size / token budget) là một tham số cần điều chỉnh: chunk quá nhỏ làm tăng overhead do phải chạy nhiều iteration hơn cho cùng một prefill; chunk quá lớn quay lại vấn đề ban đầu — đây là công cụ để đánh đổi giữa throughput và latency, không phải một giá trị “đặt một lần rồi quên” (Agrawal et al., OSDI 2024).
Scheduling: server quyết định ai được chạy
Continuous batching và chunked prefill chỉ là hai kỹ thuật cụ thể. Đứng sau chúng là một bài toán tổng quát hơn: ở mỗi iteration, scheduler của serving engine phải quyết định chính xác việc gì sẽ chạy tiếp theo.
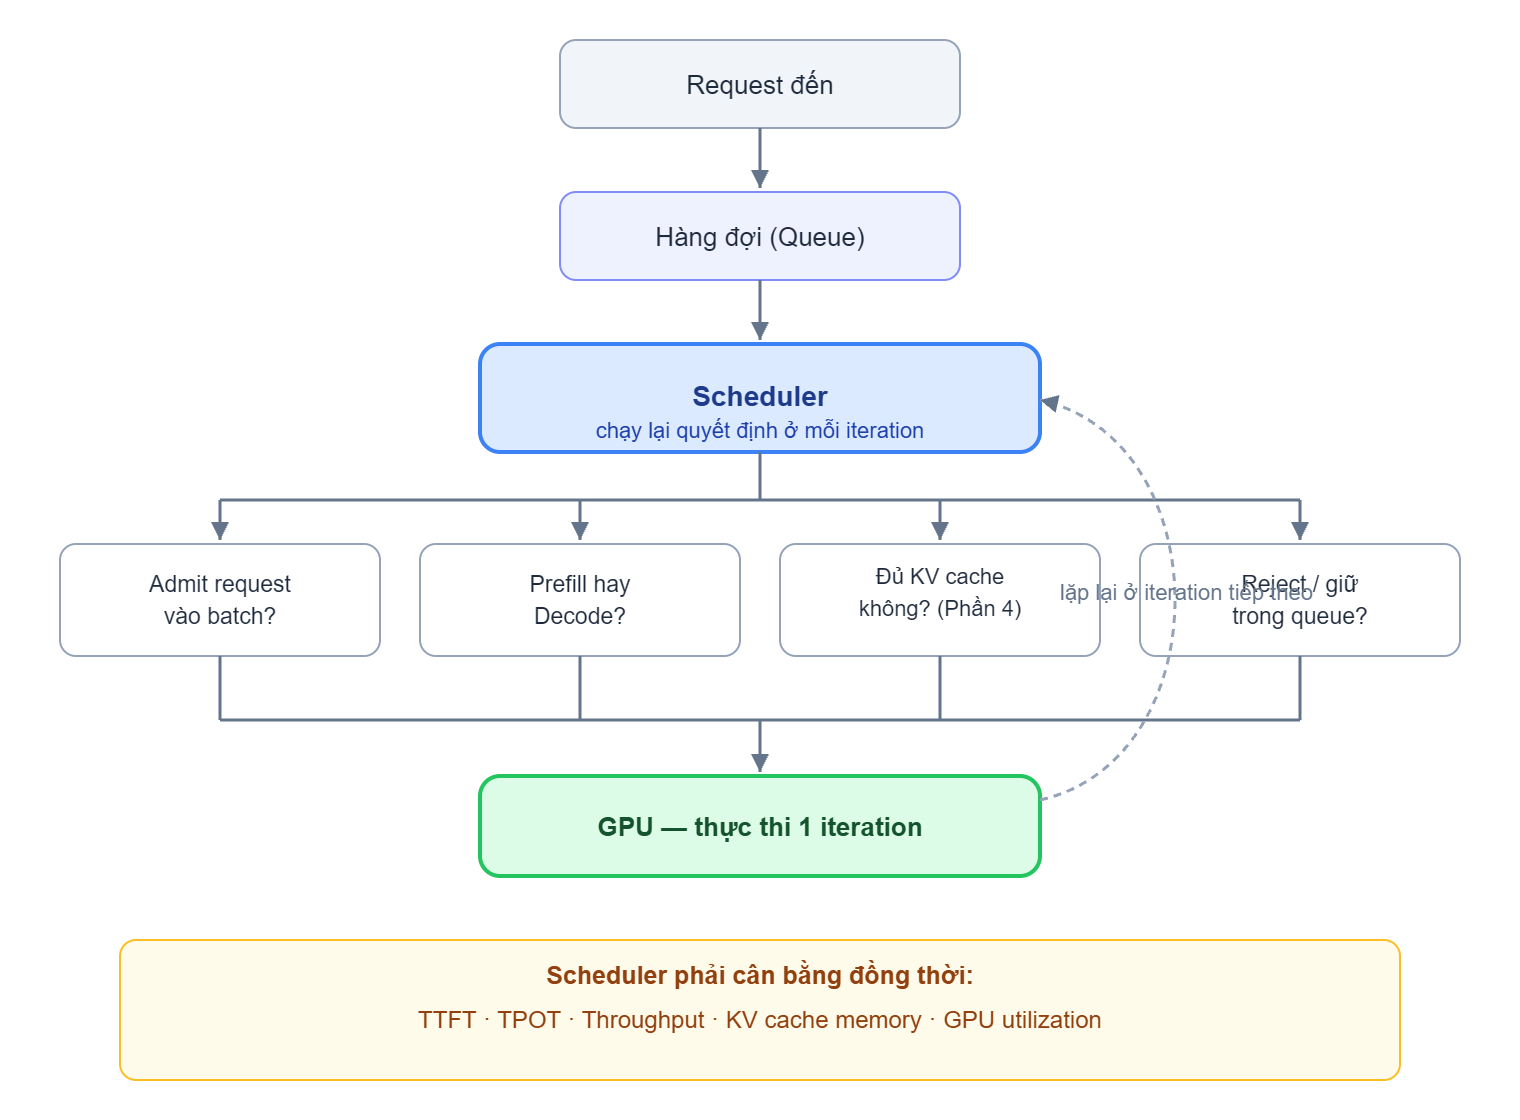
Với mỗi request đang chờ hoặc đang chạy, scheduler phải trả lời liên tục: có admit request mới vào batch không? Nếu có, xử lý phần prefill hay tiếp tục decode của nó? Có đủ KV Cache khả dụng để nhận thêm không? Nếu không đủ điều kiện, request đó reject hẳn hay tiếp tục giữ trong hàng đợi?
Điều quan trọng: scheduler không tối ưu một chỉ số duy nhất — nó phải cân bằng đồng thời TTFT, TPOT, throughput tổng, dung lượng KV Cache còn trống, và mức độ tận dụng GPU. Đây chính là bài toán goodput mà DistServe hình thức hóa — thông lượng tối đa đạt được trong khi vẫn đáp ứng ràng buộc độ trễ đã cam kết (Zhong et al., OSDI 2024).
Đánh đổi giữa Latency và Throughput
Có một đánh đổi nền tảng, độc lập với việc bạn dùng kỹ thuật scheduling nào tinh vi tới đâu:
| Batch size | Latency mỗi request | Throughput hệ thống |
|---|---|---|
| Nhỏ (ví dụ = 1) | Thấp — không phải chờ, không bị request khác cạnh tranh | Thấp — GPU phần lớn thời gian rảnh, không tận dụng được song song |
| Lớn (ví dụ = 100) | Cao hơn — mỗi bước decode phải “chia sẻ” GPU với nhiều request hơn | Cao — GPU bận rộn liên tục, tổng số token/giây tăng mạnh |
Orca và Iteration-Level Scheduling — một case study lịch sử
Nhìn lại toàn cảnh: trước Orca, “chuẩn công nghiệp” cho serving generative model gần giống hệt static batching — nhận request, gom vào batch, chạy tới khi xong mới trả kết quả. Cách nghĩ này thực chất đang mượn nguyên tư duy serving các model có output cố định độ dài, áp lên một workload hoàn toàn khác bản chất.
Đóng góp cốt lõi của Orca (Yu et al., OSDI 2022) không chỉ là một tối ưu kỹ thuật — nó là một thay đổi tư duy: scheduler không còn nghĩ theo đơn vị request, mà theo đơn vị iteration/bước sinh token. Một khi đã chấp nhận đơn vị lên lịch nhỏ hơn này, hàng loạt kỹ thuật khác — chunked prefill, prefix caching, prefill/decode disaggregation — đều trở thành các biến thể tinh chỉnh thêm trên cùng một nền tảng tư duy đó, chứ không phải những phát minh độc lập, rời rạc.
Chọn serving engine nào?
Từ các phần trên, ta đã nói về continuous batching, PagedAttention, RadixAttention, chunked prefill, KV Cache quantization — toàn những kỹ thuật bên trong một serving engine. Nhưng thực tế, gần như không ai tự viết engine từ đầu nữa. Câu hỏi thực dụng hơn nhiều là: chọn engine nào?
Bốn cái tên xuất hiện thường xuyên nhất: vLLM, SGLang, NVIDIA TensorRT-LLM, và Hugging Face TGI (Text Generation Inference).
vLLM là engine ra đời từ paper PagedAttention (Kwon et al., SOSP 2023), phát triển từ dự án nghiên cứu tại UC Berkeley. Theo README chính thức, vLLM hỗ trợ GPU NVIDIA, AMD, Intel, CPU x86/ARM/PowerPC, cùng nhiều plugin phần cứng khác (Google TPU, Intel Gaudi, IBM Spyre, Huawei Ascend, Rebellions NPU, Apple Silicon, MetaX GPU…), và hỗ trợ hơn 200 kiến trúc model trên Hugging Face.
SGLang là engine đứng sau RadixAttention (Zheng et al., NeurIPS 2024), hiện do tổ chức phi lợi nhuận LMSYS duy trì. Theo README chính thức, SGLang hỗ trợ GPU NVIDIA (bao gồm cả dòng GB200/B300 mới), AMD, Intel Xeon CPU, Google TPU, và Ascend NPU, với hơn 400.000 GPU đang chạy SGLang trong production trên toàn thế giới — được các tổ chức như xAI, NVIDIA, AMD, LinkedIn, Google Cloud, Microsoft Azure, AWS sử dụng. Điểm mạnh nổi bật nhất của SGLang nằm ở workload có nhiều phần đầu (prefix) trùng lặp — chatbot dùng chung system prompt, RAG lặp lại cùng tài liệu, agent nhiều lượt — nhờ RadixAttention tự động phát hiện và tái sử dụng KV Cache đã tính. SGLang cũng là engine được đội DeepSeek chính thức khuyến nghị để phục vụ các model DeepSeek (V3, R1…) ngay từ ngày phát hành.
Tổng hợp lại thành khung quyết định thực dụng:
| Tình huống | Nên chọn | Vì sao |
|---|---|---|
| Không chắc chắn, cần lựa chọn “an toàn” | vLLM | Hỗ trợ phần cứng rộng nhất, cộng đồng lớn nhất, dễ deploy nhất |
| Chatbot/agent/RAG dùng chung system prompt hoặc ngữ cảnh | SGLang | RadixAttention phát huy tối đa lợi thế đúng tình huống này |
| Đang serving model họ DeepSeek | SGLang | Engine được chính đội DeepSeek khuyến nghị và tối ưu riêng (MLA, MoE routing) |
| Hạ tầng toàn NVIDIA, cần vắt kiệt throughput cho model ổn định lâu dài, sẵn sàng đầu tư thời gian build/tune | TensorRT-LLM | Tối ưu sâu nhất cho hệ sinh thái NVIDIA |
| Đang chạy TGI trong production | Giữ nguyên, lên kế hoạch migrate | TGI không còn nhận tính năng mới hay hỗ trợ kiến trúc model mới từ cuối 2025 |
Bên cạnh bốn cái tên chính, thị trường 2026 xuất hiện thêm vài dự án được nhắc tới như “ứng viên thứ năm” — ví dụ Modular MAX (biên dịch kernel bằng ngôn ngữ Mojo, được quảng cáo vượt vLLM trên một số model dense ở tải cao) hay Aphrodite Engine (hướng tới hỗ trợ checkpoint dạng cộng đồng như GGUF/EXL2 và các sampler nâng cao). Chưa có đủ dữ liệu benchmark độc lập, đa nguồn để đánh giá các dự án này ở mức chi tiết như bốn cái tên trên — nên xem đây là gợi ý để theo dõi thêm, không phải khuyến nghị.
Kết luận
Serving một LLM production-grade không phải là “chạy model nhanh hơn” — đó là bài toán hệ thống nhiều lớp: hiểu prefill/decode có đặc tính trái ngược nhau, quản lý KV Cache sao cho không lãng phí VRAM, lên lịch ở cấp độ iteration thay vì request, và biết đánh đổi giữa latency và throughput tùy workload. Một model 70B benchmark đẹp trên máy cá nhân không nói lên điều gì về việc nó có phục vụ nổi 5000 request đồng thời hay không — câu trả lời nằm ở engine serving đứng sau nó, chứ không nằm ở bản thân model.